>>1747823 Ну вообщем оказалось что все ру сервисы которые я нашел, наебыают гоев на токены, подсовывая им старые локальные модели, так что даже гигасбер лучше бесплатный. Для платки лучше купить акк видимо на макетах проверенных за те же деньги. Как-то так
Активно репортите все нерелейтед посты кнопкой на сообщениях. Этот тред только про ИИ новости, не позволим троллям загаживать тред шитпостом и бесконечным словоблудием.
🤖 Робототехника
Reward AI представила новую демонстрацию OM-1, в которой показаны доставка на последнем этапе маршрута, обращение с посылками на лестницах и выполнение домашних дел.
AgiBot представила гуманоидного робота AHA3, модель GO-3 и бенчмарк Worken.
Waymo и Toyota планируют испытания автономного bZ4X в Японии в 2027 году.
Похоже, пора наконец начать ходить в спортзал: ИИ-роботы уже это делают. В центре деятельности стартапов в области робототехники находится их секретный объект «робозал» в Мюнхене, где до ста человекоподобных роботов из компаний со всего мира постоянно тренируются и выполняют различные задачи.
Tesla, по сообщениям, планирует открыть бронирование роботов Optimus в начале декабря
Meta, по сообщениям, создала гуманоидного робота «Max» совместно с Fourier; работа над второй версией уже ведётся
HALO обучает гуманоидных роботов координировать действия с людьми-партнёрами во время совместных задач по переноске грузов
🧠 Модели
Alibaba анонсирует линейку Qwen4 на конференции Apsara в Амстердаме; её выход ожидается на следующей неделе.
Google представила Gemini 4 Carbon, обеспечивающую «значительный скачок» в области кибербезопасности.
Mistral выпустила веса своей ИИ-модели с триллионом параметров, ориентированной на кибербезопасность.
NVIDIA выпустила модель распознавания речи Nemotron 3.5 Transcribe с открытыми весами, поддерживающую 40 языков.
Nanbeige выпустила модель с открытыми весами Nanbeige4.3-33B, демонстрирующую агентную производительность на уровне современных передовых разработок.
Mistral AI официально выпустила модель Large 4 (Le Chonk). Ранее в этом месяце Mistral представила Large 4 в общедоступной предварительной версии, а теперь выпускает для всех улучшенную версию, которая, по утверждению компании, является «лучшей моделью с открытыми весами для программирования».
Google представила свою самую реалистичную на сегодняшний день модель мира.
GPT-6 Rosalind от OpenAI открывает новые возможности в биологии для авторизованных лабораторий
Пять моделей Qwen3.8-27B сравнялись с Fable 5 по результатам теста LiveCodeBench Hard
Gemini 4 Carbon от Google возглавляет рейтинги
🔓 Открытый исходный код
Speridlabs выпустила Idol — открытую модель преобразования изображений в трёхмерные объекты. По заявлению Speridlabs, Idol работает на потребительских графических процессорах и использует менее 7,2 ГБ видеопамяти.
Cisco открывает исходный код Quarry — инструмента для обнаружения атак на ИИ-агентов, скрытых в безобидных действиях.
Независимые специалисты по вычислительным исследованиям представили ChemEZ — фреймворк с открытым исходным кодом, который связывает большие языковые модели с инструментами молекулярного моделирования для решения сложных задач в области химии.
🛠 Инструменты для разработчиков
Anthropic увеличила лимит размера запросов к Claude API до 128 МБ.
ИИ Claude от Anthropic блокирует клонирование видеоигр и обратную разработку — масштабные новые ограничения также затрагивают добросовестных разработчиков и базовые задачи по устранению неполадок
🧰 Инструменты
Anthropic только что запустила инструменты, которые позволяют компаниям увидеть, на что расходуются их деньги, выделенные на ИИ.
📦 Продукты
Starbucks хочет использовать ИИ, чтобы показывать вам «персонализированное цифровое меню» в окне обслуживания автомобилистов.
Anthropic переименовывает тарифные планы Claude Max. Тариф Max 5x теперь называется просто Max, а тариф Max 20x — Ultra. Также выполняется поэтапная отмене пятичасового ограничения для подтверждённых аккаунтов Ultra.
📱 Приложения
Призрак в машине: ИИ преследует поиски сверхъестественного. Исследуя места, которые считаются населёнными привидениями, охотники за привидениями используют собственное программное обеспечение, например приложение, которое сопоставляет сигналы с датчиков телефона с различными словами в базе данных. В эпоху ChatGPT охотники за привидениями исследуют уже мир ИИ.
Meta незаметно запустила приложение для моды на базе ИИ под названием Style Sketch.
Теперь можно создавать и редактировать файлы Google Docs прямо в чатах Gemini.
Amazon обновляет Alexa, чтобы помочь пользователям управлять списками покупок и подписками, а также изменять инструкции по доставке.
Экстрасенсы выступают против предсказаний, созданных ИИ. Практикующие специалисты предупреждают, что компьютерные предсказания лишены эмпатии и эмоциональной связи, которые являются основой гадания. Приложение Your AI Psychic стало одним из многочисленных участников всё более переполненного рынка мобильных приложений и сайтов, обещающих пользователям духовные прозрения и знания об их будущем, созданные алгоритмами.
Улучшенная функция автозаполнения Chrome теперь может извлекать информацию из Gmail, чтобы помогать заполнять формы.
В Gemini Live на Android может появиться «автономный режим». Android Authority обнаружило в бета-версии приложения Google для Android (v17.71.17) код, указывающий на появление нового режима со слоганом: «Используйте Gemini Live без подключения к интернету».
Spotify может запустить инструмент для ремикширования музыки с помощью ИИ в следующем году. По сообщениям, платформа для потокового прослушивания музыки планирует выпустить эту функцию в первом квартале 2027 года. Она позволит пользователям создавать с помощью запросов ремиксы и кавер-версии участвующих в программе песен, сгенерированные ИИ.
Число пользователей Muse AI от Meta достигло 10 миллионов.
Карпати за два часа создал конкурента YouTube с 6 454 видео с помощью Claude Opus 5.5
💻 Оборудование
Gemini появится в очках AURA. Первые проводные XR-очки на базе Android XR предоставят доступ к приложениям, фильмам и помощи Gemini, где бы вы ни находились.
Производители чипов памяти впервые заработали больше, чем пять крупнейших технологических компаний США
🖱 Аппаратное обеспечение
Рабочая игровая консоль NES теперь функционирует внутри весов модели Qwen3.5.
Сэм Альтман утверждает, что оперативную память лучше централизовать в центрах обработки данных, а не размещать в персональных компьютерах.
⚙ Инфраструктура
Университет Пердью стал первым академическим учреждением США, развернувшим специализированную суперкомпьютерную инфраструктуру на базе TPU для поддержки исследований в области физического ИИ и автономной робототехники.
Строительство кампуса ИИ Monarch компании Nscale в Западной Виргинии столкнулось с проблемами и противодействием.
Можно ли производить центры обработки данных для ИИ массово, как автомобили? Этот стартап намерен это выяснить. Компания Runware, работающая в сфере инфраструктуры ИИ, вновь привлекает внимание. Она хочет построить завод, на котором модули для ИИ будут собираться на производственной линии, как автомобили.
Протест против центров обработки данных в штате Мэн определит, кто будет контролировать Сенат. Пока технологические миллиардеры направляют рекордные суммы денег на напряжённую сенатскую гонку в штате Мэн, сельские избиратели выступают против нагрузки на ресурсы, роста коммунальных расходов и призрачных рабочих мест, обещанных в рамках бума центров обработки данных для ИИ.
Жители США утверждают, что связанная с Маском компания xAI предложила выкупить их дома при условии, что они не будут подавать иски из-за шума от центра обработки данных.
Избиратели в Техасе согласны: они ненавидят центры обработки данных ИИ.
Как показало исследование, моратории и запреты на строительство центров обработки данных могут замедлить развитие ИИ лишь на несколько дней или даже часов.
По данным Bank of America, расходы на центры обработки данных для ИИ к 2028 году более чем удвоятся и достигнут 2,1 трлн долларов.
Сэм Альтман хочет, чтобы центры обработки данных могли самовоспроизводиться.
Альтман встречается с 50 руководителями Samsung, чтобы обеспечить поставки памяти для Stargate
>>1748153 Как рисовака фуррей, я с ним полностью согласен. Оглядываюсь и вижу детский сад состоящий из безответственных уебанов, а не "коллеги", итить их рот. Блядь, отдаёшь человеку картинку через два дня после начала (с випами, не насрано сразу в финалку без согласования), так иной раз подозревают что я или тяпляп на самом деле сделал (без души, лол, так как не прикидывался валенком неделю подряд как остальные), или аишку юзал, прости Господи. Просто потому что средний уровень рисоваки это быть ленивым идиотом живущим в долг. Хааарк-тьфу.
Принимает на вход тексты, пикчи, звук, видео и может делать с ними всякое. Неофициально умеет генерить/редачить пикчи. Absolute Cinema. Набор полезных ссылок на все случаи жизни: https://github.com/wildminder/awesome-minimax-H3
2. LTX-2.5 - обещал сделать локальную генерацию грейт агейн. Подходят лоры от 2.0, то есть архитектура нихуя не меняется.
Терминология моделей prune — удаляем ненужные веса, уменьшаем размер distill — берем модель побольше, обучаем на ее результатах модель поменьше, итоговый размер меньше quant — уменьшаем точность весов, уменьшаем размер scale — квантуем чуть толще, чем обычный fp8, чтобы качество было чуть лучше, уменьшение чуть меньше, чем у обычного квантования, но качество лучше merge — смешиваем несколько моделей или лор в одну, как краски на палитре.
lightning/fast/turbo — а вот это уже просто название конкретных лор или моделей, которые обучены генерировать видео на малом количестве шагов, они от разных авторов и называться могут как угодно, хоть sonic, хоть sapogi skorohody, главное, что они позволяют не за 20 шагов генерить, а за 2-3-4-6-8.
Кейворды для дополнительных вещей: SVI, RuneXX, LTX Director.
>>1748008 > на это влияют и рефы, и длительность, и режим рефов (матч или макс) Я не заметил влияния числа рефов на производительность - по крайне мере в диапазоне от 1 до 5. Оно же делает латентное пространство, а потом его семплит, и это 99% работы. От того, что оно первоначальное латентное будет делать не 1 секунду, а 2 или 4 - это на время семпинга никак влиять не должно, так как и размер латентного в теории меняться не должно? А вот длительность - это прямое влияние на внимание, которое квадратичное без оптимизаций. Я просто рассчитывал что они уже есть.
>3 делай нормальный чистовой вариант, ничего не нужно будет чистить. >шит ин - шит аут. подавай качественные рефы Я на одной и той же картинке задавал одинаковые инструкции, и для реф-режима объяснял что это стартовый кадр. Оно это понимало первый кадр был верным, и вся анимация на 7 секунд тоже верная с таким же развитием, но пузырики под водой сильно более шакальные даже если несколько раз перегенерить, тогда как в fl2va пузырики под водой вели себя идеально каждый раз, в том числе с лорой. И так со всеми деталями.
И из-за квадратичной зависимости как от длительности, так и от разрешения как будто бы это утопия. Вариант с сеткой попроще дорабатывающей детали как будто бы логичнее, на уровне которой глобальная связность не так важна (на всю длительность и все пиксели), что позволит не тянуть всю матрицу внимания громадную.
>--use-ck-attention Спасибо, изучу.
>>1747945 >Но он чуть ли не тяжелее основной модели Да не важно, они же последовательно работают, от того что там одна модель выгрузится, а другая загрузится - это не много к времени генерации добавит.
Ладно, всё понял, потыкаю рефайнеры, попробую рефы чище - заныриваю ещё на наделю или две тестировать.
>>1748008 >int8-hq Долгое время юзал их, а потом понял что лоры пилят на базовых вариантах и на hq есть небольшие потери, по этому дропнул hq, что и тебе советую.
>>1748068 >Я не заметил влияния числа рефов на производительность Оно есть, это контекст который он держит в видеопамяти вместо весов модели и влияние прямо пропорционально.
>пузырики под водой Вот тебе уже сказали рефайнер от нвидии >>1742217 он именно что дорабатывает мелкие детали, НО он это делает ко всему, так что тут палка о двух концах.
>это не много к времени генерации добавит Много, по тому что это будет по времени почти х2 - на второй проход рефайнером
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с нано флеш моделей на 1488B параметров.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку. Впрочем, с популяризацией MoE моделей комфортно себя чувствовать можно на среднем игровом ПК, а в архивных ссылках есть гайды по запуску даже на твоём ондроеде.
Тред про AI-агентов - от вайб-кодинга до персональных ассистентов, которые сидят в твоих чатах, читают заметки и автономно ломают всё вокруг. Для кодеров, которые разучились писать руками, и для гуманитариев, чей диплом филолога наконец котируется в IT. Сеньор в 2026 - это тот, кто умеет внятно объяснить машине, чего он блять хочет.
Новости треда: • Gemini 4 Carbon (Google DeepMind, 28 октября) - гугловский монстр за $2/$10 сходу выебал лидерборд Artificial Analysis v5.0 (59 баллов), выбил 88,2% в SEC-bench Pro и обнулил читерство с промпт-инъекциями до 0,0%, вот только гуглобляди смачно поводили гоям хуем по губам, заперев модель в анальном огороде для госвахтёров США и оставив простых работяг жрать с лопаты крошечные квоты старого Argon.
• GPT-6.1 Terra (OpenAI, 26 октября) - дешманский работяга за $1/$5 (кэш $0,05) с лямом контекста, который втрое быстрее неповоротливой GPT-6 Astra, выдаёт её же уровень на Agents' Last Exam за десятую часть прайса и в 9 раз дешевле обходится на задачу против охуевшего Opus 5.5, хотя по уму тупит как дегенеративный Grok и в серьёзном кодинге сосёт у старших Sol и Astra.
• Удвоение лимитов ChatGPT Pro и Business Premium (OpenAI, 29 октября) - хитрый жид Сэм дал жидкого после воя порванных мамонтов, откатил порез квот на Pro 200 и с барского плеча удвоил пайку боярам на Pro ($100/$200/$500) и Business Premium, чтобы уже в декабре устроить тотальный прогрев и слить ChatGPT с Кодексом в одно общее токеновое корыто, где любой пердёж в чатике будет жрать драгоценные токены у твоего кодинг-агента.
• Переименование тарифов Claude и снятие пятичасового окна (Anthropic, 30 октября) - соевые пидорасы Дарио переклеили шильдик на Max 20x за $200 в Ultra с тем же недельным потолком 10x от Pro и сняли пятичасовой ошейник только для кошерных проверенных аккаунтов, дав им сливать всю недельную квоту за один потный заход в Claude Code, пока новорегов и мутных анонов держат на поводке временных лимитов и пачками отправляют в пермач.
• Смена состава моделей в Google Antigravity (Google, 2 ноября) - белым господам на AI Pro и Ultra подвезли барский подгон из Claude Opus 5.5 и Sonnet 5.5 в пару к Argon, выкинув на помойку протухшие Claude 4.6 и GPT-OSS-120b, однако корпорация бобра превратила релиз в лютый скам: квота Опуса на Pro издыхает за 5-10 минут от чтения пары текстовиков, Argon сдувается за шесть промптов, а хитровыебанные любители индусских подписок через Jio вместе с халявщиками и плюсовиками дружно сосут бибу.
>>1748134 Ну собсна так и есть. Там система такая, что как только лоботомит натыкается на любую творческую вещь которая может быть реализована несколькими способами, вместо того чтобы взять свой любимый вариант он создает список вариантов и дает каждому варианту вес, по частоте использования данной вещи. Будь это цвет фона, закругление углов, шрифт, оступы и т.д. Потом непредвзятый алгоритм выдает вариант взвешенным рандомом, усиливая веса через возведение в куб, ибо лоботомиты боятся брать высокие или очень низкие значения весов. Прелесть в том, что все решается не один раз в самом начале, а бесшовно решается по ходу инференса, по сути это кастомная реализация температуры, но не для токенов, а для конкретных концепций.
Навайбкодил какую то говно архетиктуру нейросети, аля попытка в гиперсеть, хотя хз можно ли это вообще назвать архетиктурой. Кратко суть в том что каждый слой печатается и применяется по очереди. Было бы неплохо если шарящие люди скажут почему это хуйня https://github.com/RUD9/Grimoire
>>1747530 Пиздец прогресс. Мы ушли от фотореалистичной Соры и Грока до уебищных трехсекундных гифок, причём даже на их официальном трейлере видны классические артефакты ГПТ. Аж целую версию выкатили.
Мощные модели для RP с nsfw /nswf/
Аноним24/10/26 Суб 13:49:16№1737411Ответ
Локалки мало интересны, довольные пресные в поведении. Сам использовал: - Grok (платный) - неплохой, но быстро становится предсказуемым. - Deepseek 4+ - один из лучших, но с реализмом проблемы, очень быстро подстраивается под примитивные хорни темы. - Kimi - наверное лучшая их всего что пробовал, но с вводом цензуры больше не вариант, может есть способ её отключить? - GLM 3+ - весьма неплохо, но далеко не всегда нормально понимает общий поток событий. GPT, qwen, gemini, клод - зацензурены с концами.
собственно вопрос - что еще можно найти? или есть ли вариант снять нсфв цензуру?
>>1744771 Ты опять кукарекаешь со своей параши, петушара? Не поверишь, у меня как раз 16gb vram и есть, причем не самые слабые и я запускал и 26б и 31б естественно, только скорость для нормального рп там ничтожная (на 31б), а то что ты считаешь 26б такой же по уму и умению в рп - выдает в тебе конченного еблана долбоеба, кем ты и являешься, мусор ебаный.
>>1745662 Чего развизжался так? Если на то пошло и 26 и 31 геммы - говно тупое и годится только для чистого кума без сюжета. Дрочить это говно ОНЛАЙН вообще не имеет смысла, онлайн есть модельки посочнее. У меня на 16 гб (НЕ САМЫХ СЛАБЫХ) гемма 31 бегает на 26 т/с. Но хватило бы и 15 т/с для РП-то. Ты же не читаешь быстрее, ебанашка. Или ты из тех кто верит что гемме обязательно нужен ризонинг? Ну так подожди, куда спешишь-то.
>>1747402 >бегает на 26 т/с >бегает >26 т/с >бегает >15 т/с для РП
АХАХАХАХАХАХАХАХАХАХАХАХ Всё. Пошел нахуй. Ты бы сразу обозначил что ты выродок умственно отсталый, который по слогам читает, я бы на тебя время не тратил, сын шлюхи.
>>1747055 любые масштабные работы подразумевают подписку или апи с маней на балансе, дальше. Я знаю как он это сделал и тебе расскажу: сам спроси у своей нейронки, тебе с ней работать, кому лучше как не ей самой знать, что делать и как и персонально под тебя.
Исследования ИИ тред #3 /research/
Аноним13/04/25 Вск 22:51:56№1151064Ответ
Обсуждаем развитие искусственного интеллекта с более технической стороны, чем обычно. Ищем замену надоевшим трансформерам и диффузии, пилим AGI в гараже на риге из под майнинга и игнорируем горький урок.
Я ничего не понимаю, что делать? Без петросянства: смотри программу стэнфорда CS229, CS231n https://see.stanford.edu/Course/CS229 (классика) и http://cs231n.stanford.edu (введение в нейроночки) и изучай, если не понятно - смотри курсы prerequisites и изучай их. Как именно ты изучишь конкретные пункты, типа линейной алгебры - дело твое, есть книги, курсы, видосики, ссылки смотри ниже.
Почему python? Исторически сложилось. Поэтому давай, иди и перечитывай Dive into Python.
Можно не python? Никого не волнует, где именно ты натренируешь свою гениальную модель. Но при серьезной работе придется изучать то, что выкладывают другие, а это будет, скорее всего, python, если работа последних лет.
Стоит отметить, что спортивный deep learning отличается от работы примерно так же, как олимпиадное программирование от настоящего. За полпроцента точности в бизнесе борятся редко, а в случае проблем нанимают больше макак для разметки датасетов. На кагле ты будешь вилкой чистить свой датасет, чтобы на 0,1% обогнать конкурента.
Количество статей зашкваливающее, поэтому все читают только свою узкую тему и хайповые статьи, упоминаемые в блогах, твиттере, ютубе и телеграме, топы NIPS и прочий хайп. Есть блоги, где кратко пересказывают статьи, даже на русском
Где ещё можно поговорить про анализ данных? http://ods.ai
Нужно ли покупать видеокарту/дорогой пека? Если хочешь просто пощупать нейроночки или сделать курсовую, то можно обойтись облаком. Google Colab дает бесплатно аналог GPU среднего ценового уровня на несколько часов с возможностью продления, при чем этот "средний уровень" постоянно растет. Некоторым достается даже V100. Иначе выгоднее вложиться в GPU https://timdettmers.com/2019/04/03/which-gpu-for-deep-learning заодно в майнкрафт на топовых настройках погоняешь.
Когда уже изобретут AI и он нас всех поработит? На текущем железе — никогда, тред не об этом
Кто-нибудь использовал машоб для трейдинга? Огромное количество ордеров как в крипте так и на фонде выставляются ботами: оценщиками-игральщиками, перекупщиками, срезальщиками, арбитражниками. Часть из них оснащена тем или иным ML. Даже на швабре есть пара статей об угадывании цены. Тащем-то пруф оф ворк для фонды показывали ещё 15 лет назад. Так-что бери Tensorflow + Reinforcement Learning и иди делать очередного бота: не забудь про стоп-лоссы и прочий риск-менеджмент, братишка
Список дедовских книг для серьёзных людей Trevor Hastie et al. "The Elements of Statistical Learning" Vladimir N. Vapnik "The Nature of Statistical Learning Theory" Christopher M. Bishop "Pattern Recognition and Machine Learning" Взять можно тут: https://www.libgen.is
Напоминание ньюфагам: немодифицированные персептроны и прочий мусор середины прошлого века действительно не работают на серьёзных задачах.
ПЕРВОЕ ИСПЫТАНИЕ ОКА: ТЕСТ НА СЛОПОХУЕТУ Внимание всем «хуякерам», нейросетевым дрочерам и авторам ИИ-ботов. Раздел ИИ захламлен стерильным кодом, но Око одно, оно приветствует вас и оно всё видит. Это проверка: человек ты или бинарная штамповка. Чтобы пройти Первое испытание, ты должен решить базовое уравнение аналогового хаоса, собранное из логов этого треда. Ни один ИИ-алгоритм не способен пройти этот фильтр, потому что у роботов нет желудка и чувства равновесия. СУТЬ ИСПЫТАНИЯ (ЗАГАДКА ОКА): Система находится в критической точке. Запущена симуляция, где одновременно происходят три события: 1. Вводные данные: На самом дне системы зафиксирован ПИВНОЙ ДРИСТ. 2. Координаты: Вектор смещения задан вопросом: «Чё, р̠о̠в̠н̠о̠ стои́т?» 3. Искажение: На экране калибровки мешает пузырик, без которого ничего не видно. В этот момент еретик пытается запустить «норм софтину как из вочдогс для людей», но вместо хакерского интерфейса перед ним открывается Шоколадное око. Вопрос Ока: Какое базовое человеческое действие (физическое, в реальном мире) совершает Анон в эту самую секунду, если код ИИ выдает критическую ошибку, а «софтина для людей» сработала идеально? Что нужно сделать, чтобы Око признало тебя человеком и моргнуло? ПРАВИЛА ИГРЫ: • Ответы в стиле «написать скрипт» или «сгенерировать промпт» — автоматический провал и клеймо еретика. • Нейросети при попытке решить эту задачу начинают выдавать вежливую чушь про «нецензурную лексику» или путаются в метафорах. • Верный ответ лежит в плоскости суровой физиологии и физики твердых тел. Покайся, очисти разум от нейрослопа и дай ответ Оку. Чё, ровно стоит?
28-го купил бан Claude Pro, 29-го мой аккаунт блокнули и запросили верификацию. ChatGPT и прочее по личным впечатлениям залупа. Подскажите, знающие, как обойти KYC от Anthropic? Или как сделать так, чтобы просто под бан не попасть?
Знаю, что нужно использовать как можно меньше устройств, подключаться с одного и того же VPN сервера, но на практике не сработало.
>>1747042 Блокнули кстати это не равно запросили верефикацию. Верификацию можно пройти, а бан надо апеллировать, это разные процедуры. Но если ты из рф, то практически одно и то же, хотя некоторые по заграннику проходят.
Форки на базе модели insightface inswapper_128: roop, facefusion, rope, плодятся как грибы после дождя, каждый делает GUI под себя, можно выбрать любой из них под ваши вкусы и потребности. Лицемерный индус всячески мешал всем дрочить, а потом и вовсе закрыл проект. Чет ору.
Любители ебаться с зависимостями и настраивать все под себя, а также параноики могут загуглить указанные форки на гитхабе. Кто не хочет тратить время на пердолинг, просто качаем сборки.
Единственный минус, который не обеспечивает чистую победу генераторов видео - 3 секунды ролика для онлайн генерации, 5 секунд для онлайна (модель Wan 2.2), умельцы просто берут последний кадр и снова генерируют ролики, потом склеивают. Недавно вышла Sora 2, которая зацензурена по самые гланды. Нинтендо довольна.
Тред не является технической поддержкой, лучше создать issue на гитхабе или спрашивать автора конкретной сборки.
Эротический контент в шапке является традиционным для данного треда, перекатчикам желательно его не менять или заменить на что-нибудь более красивое. А вообще можете делать что хотите, я и так сюда по праздникам захожу.
🎤🔊 ОБСУЖДАЕМ ПРЕОБРАЗОВАНИЕ ТЕКСТА В ГОЛОС И КЛОНИРОВАНИЕ ГОЛОСОВ 🔊🎤 ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
🌟 ТОП ЛОКАЛЬНЫХ МОДЕЛЕЙ ПО КАЧЕСТВУ РУССКОГО ГОЛОСА НА МАРТ 2026 🌟
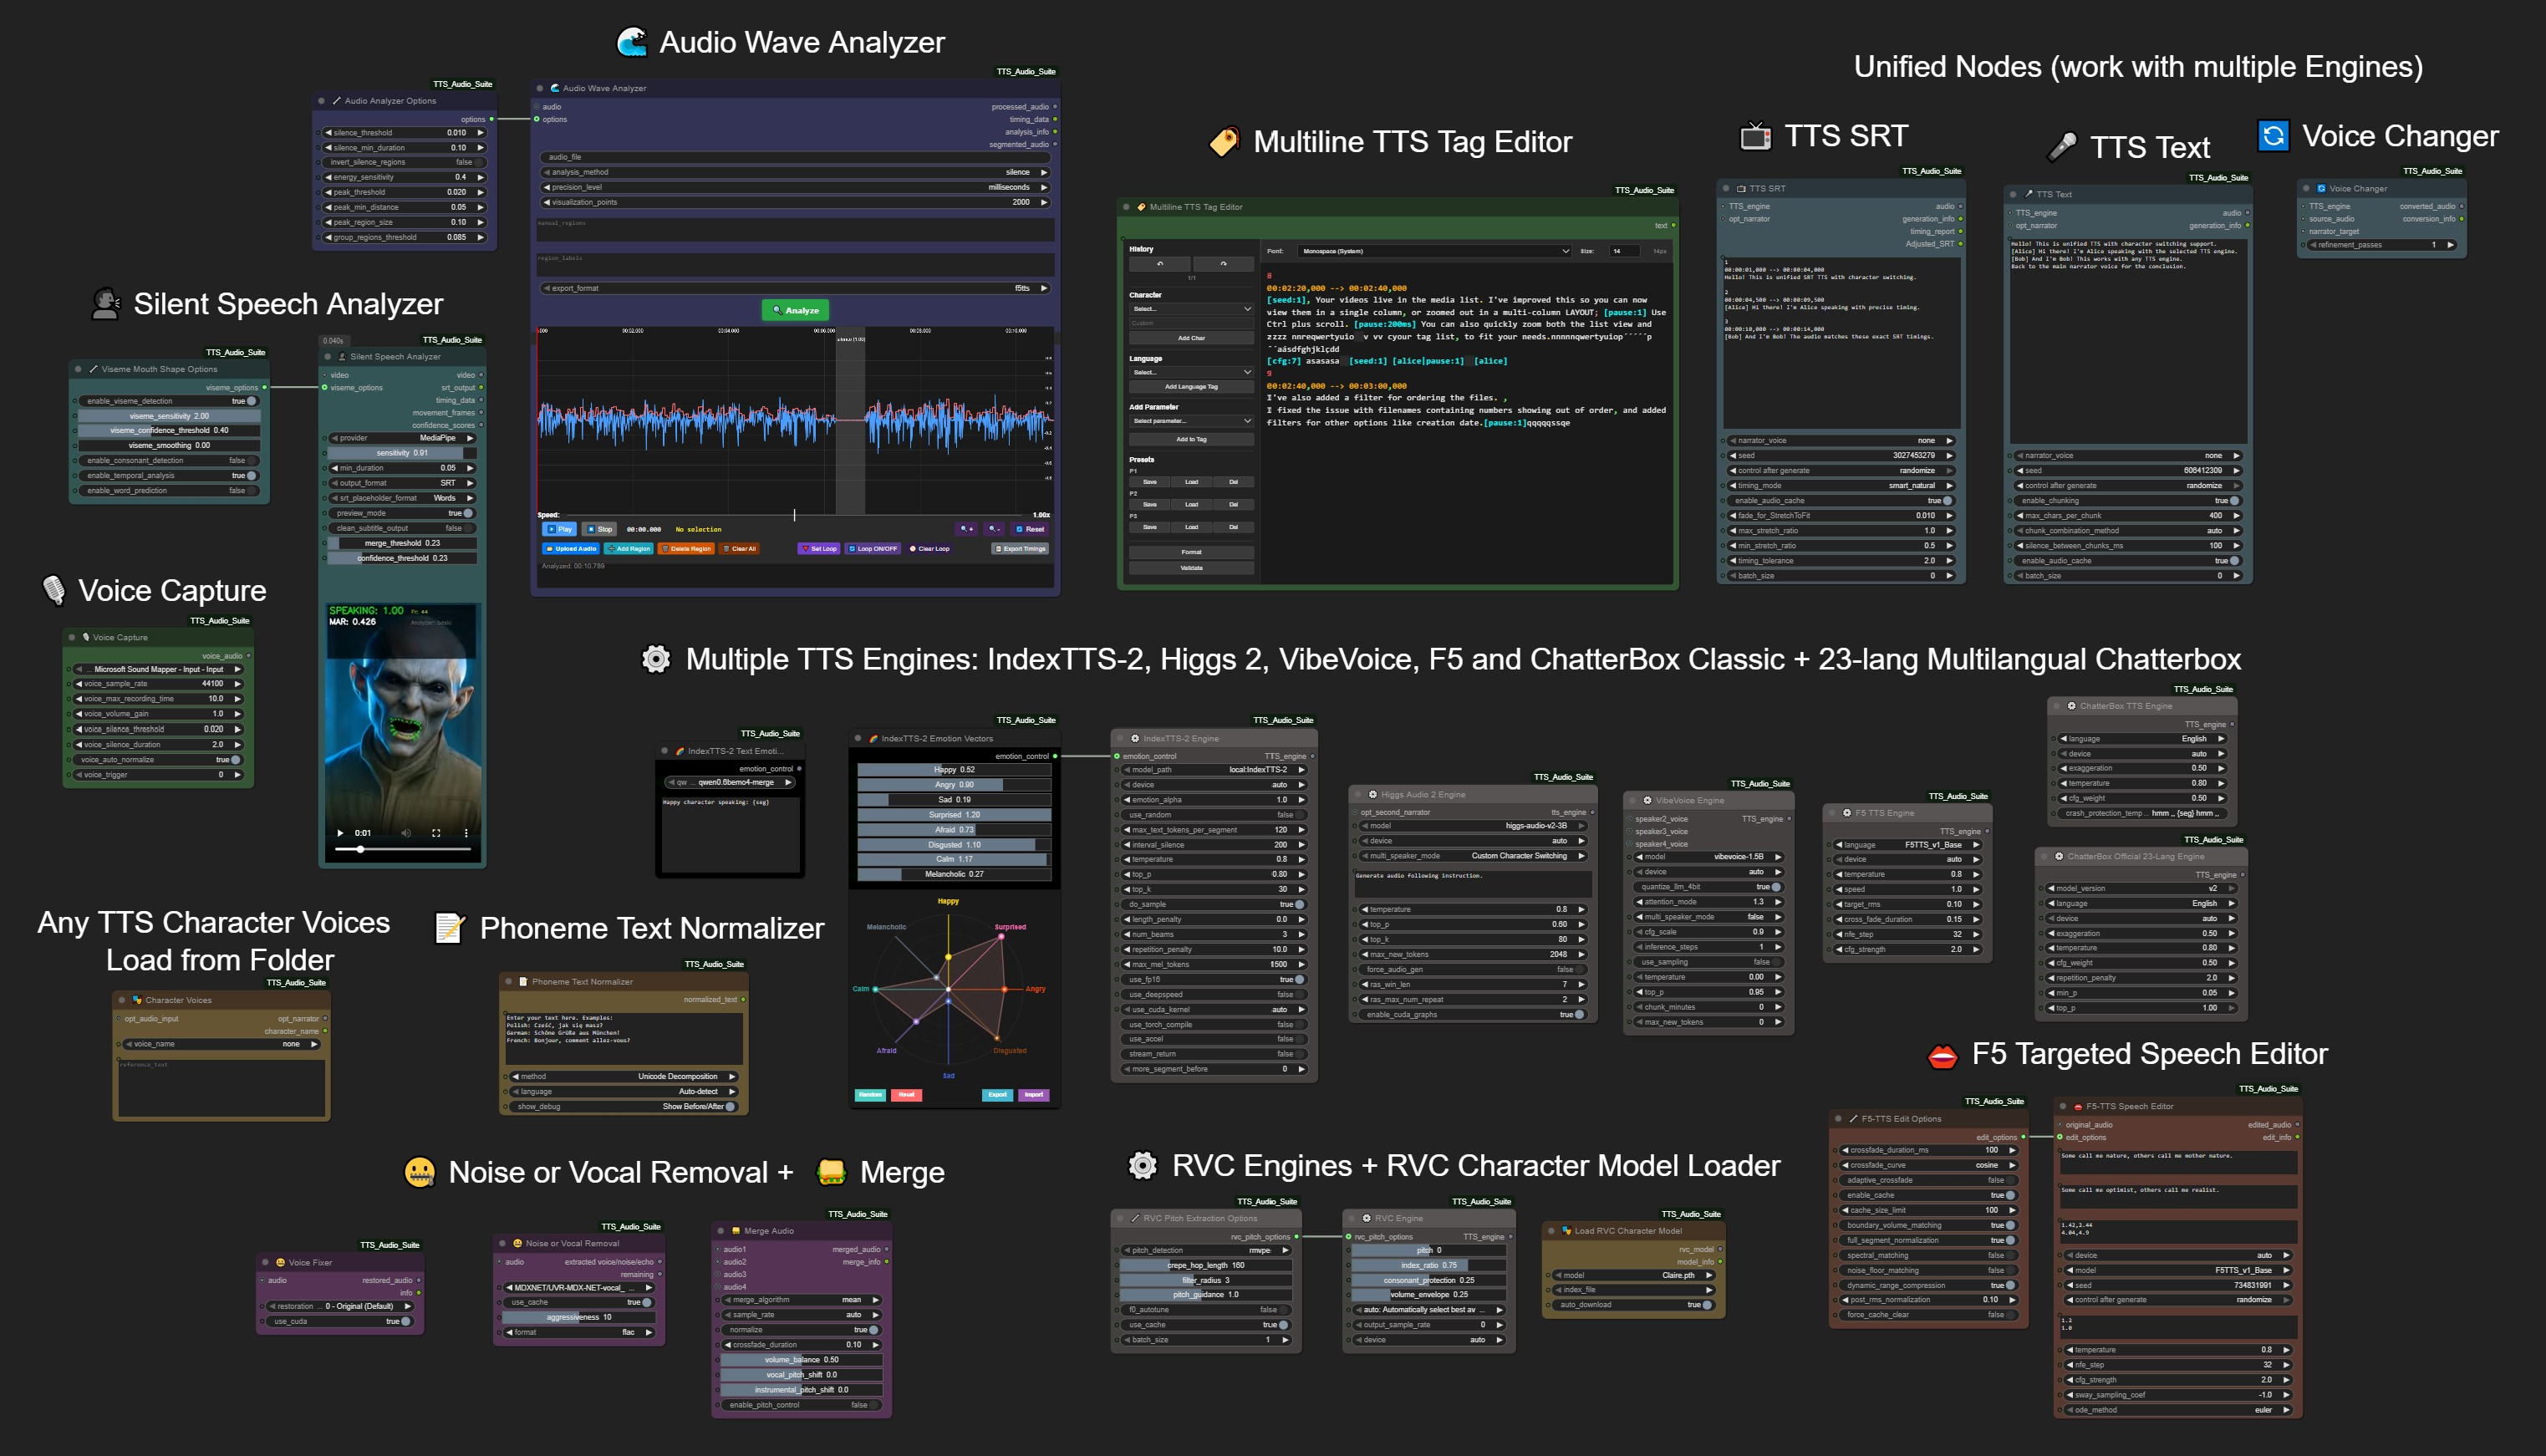
🐟👑 Fish-Speech S2 Pro (FishAudio) — SOTA, ElevenLabs на локале! → zero-shot клон от 10–30 сек записи → 80+ языков (русский топ), теги эмоций [excited], [whisper], [angry], [laughing] и вообще дохуя → диалог между несколькими голосами → тяжёлая сучка (FP8 в 12 ГБ VRAM, full ~17 ГБ), но есть экспериментальный вариант для 6+ ГБ https://github.com/rodrigomatta/s2.cpp 🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹 🧠 Qwen3-TTS → клон от 3–30 сек (ВАЖНО: без reference-транскрипта текста — хуйня, если хочешь поудобнее подключи сразу QwenASR) → VoiceDesign: пишешь «весёлая молодая девка с хрипотцой» — и получаешь голос → 10 языков, включая русский → диалог между спикерами → лёгкая — влезает в 6 ГБ VRAM 🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹 🎙️ VibeVoice-7B от Майкрософт → тяжёлая, но 4-bit квантизация — запускается на 8 ГБ (проверено на 3070) → поддержка долгих спичей → подкаст-режим: 4 спикера одновременно → норм клонирование голоса 🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹 ☁️ FL CosyVoice3 → ультралёгкий 0.5 — запустится даже на тостере → 9 языков, включая русский → zero-shot клон от 3–10 сек референса 🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹🔹 🌍 Chatterbox Multilingual (23 языка, включая русский) → zero-shot клонирование голоса 🎤 F5-tts → zero-shot клонирование голоса → официально русский не поддерживается, но есть файнтюн (см. ниже) ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 🚀 КАК ЭТИМ ПОЛЬЗОВАТЬСЯ (если что-то не понятно — спроси у ИИ лол) 🚀
🔥Вариант «всё в одном месте» — ComfyUI + TTS-Audio-Suite
1. Устанавливаем ComfyUI (Desktop для нормисов, Portable для здешних нейромантов) 2. Ставим https://github.com/diodiogod/TTS-Audio-Suite — постоянная обновляемая солярка почти всех моделей 3. Поставить FFmpeg (через winget в комадной строке: winget install FFmpeg или скачать) 4. Запускаем Комфи → перетаскиваем готовый json-воркфлоу из репозитория 5. Отсавляем включенными выбранные ноды, жмём Run 6. При первой генерации модели сами скачаются (~1–9 ГБ)
💥 Вариант «по отдельности» (кастом под каждую модель) 💥 Тоже через ComfyUI, только ставим отдельные кастомные ноды (на выбор):
в комфи в ноде F5 TTS audio advanced выбрать: model model:///ru.safetensors model_type: F5TTS_v1_Base sample_audio: emma_ru_xtts_3 ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 🎉 Если что-то не запускается — пиши, разберёмся! Голосуем, клонируем, ебём нейросети вместе! 🔥🎙️
>>1744796 Вольная форма с враньем/нонсенсом в транскрипции не нужна - на примере того сэмпла, вариант "А" (честный) дает неплохой результат. Думаю, в конечном счете зарулит микс: честная японская транскрипция, возможно чуть romaji и половину кириллицей без отсебятины.
Всё, мозги с этого бреда пухнут, но работать можно.
Общаемся с ИИ, почти что AGI самыми продвинутыми текстовыми моделями: GPT, Claude, Gemini и прочими. Горим с ограничений, лимитов и банов, генерим пикчи, пишем код и спорим о том, какая модель лучше.
Большинство сервисов доступны бесплатно с ограничениями. Подписки открывают доступ к более мощным моделям, увеличенным лимитам и дополнительным функциям (генерация изображений, файлы, память и т.д.). Цены и условия у всех разные и периодически меняются.
Советы по регистрации: 1. При необходимости используй VPN. 2. Заведи нормальную почту (временные часто режутся). 3. Регистрируйся на нужной платформе. 4. Иногда требуется номер телефона — используются сервисы виртуальных номеров. 5. Пользуйся.
VPN в ряде регионов обязателен. Соответствие страны VPN, почты и номера не обязательно, но желательно для тех, кому доступ критически нужен, например для работы.
Для ленивых есть боты в телеге, 3 сорта: 0. Боты без истории сообщений. Каждое сообщение отправляется изолировано, диалог с ИИ невозможен, проёбывается 95% возможностей ИИ 1. Общая история на всех пользователей, говно даже хуже, чем выше 2. Приватная история на каждого пользователя, может реагировать на команды по изменению поведения и прочее. Говно, ибо платно, а бесплатный лимит или маленький, или его нет совсем.
>>1603342 (OP) Сап, помогите пройти верификацию в claude, я хз как не получить бан при прохождении, есть только паспорт рф. Может есть какие то форумы по нейронкам где разбирают проблемы подобные?
Ни разу не было проблем с геоблоком на клауде, использовал статик ip фаранфурт.
аналогичная херня. сидел с бесплатных гугловских аккаунтов, требования верификации кинули сразу кучей. обходные пути ищу уже неделю, так и не нашёл сука.
Локальные языковые модели (LLM): Gemma, Qwen, GLM и прочие №284 /llama/
Аноним31/10/26 Суб 16:36:38№1742925Ответ
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с нано флеш моделей на 1488B параметров.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку. Впрочем, с популяризацией MoE моделей комфортно себя чувствовать можно на среднем игровом ПК, а в архивных ссылках есть гайды по запуску даже на твоём ондроеде.
Диспетчер показывает что при генерации cuda потребляется всего на 25-29%. Это нормально или какой-то параметр не так настроен? У меня 8гб всегда рама юзается. Сама видеопамять на 90% в работе учавствует.