В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с нано флеш моделей на 1488B параметров.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
>>1724410 Чисто ради познавательного интереса для друга как говорится. Какие промпты используются для животных? Карточки ии? Сценарий? Составляющая Персоны?
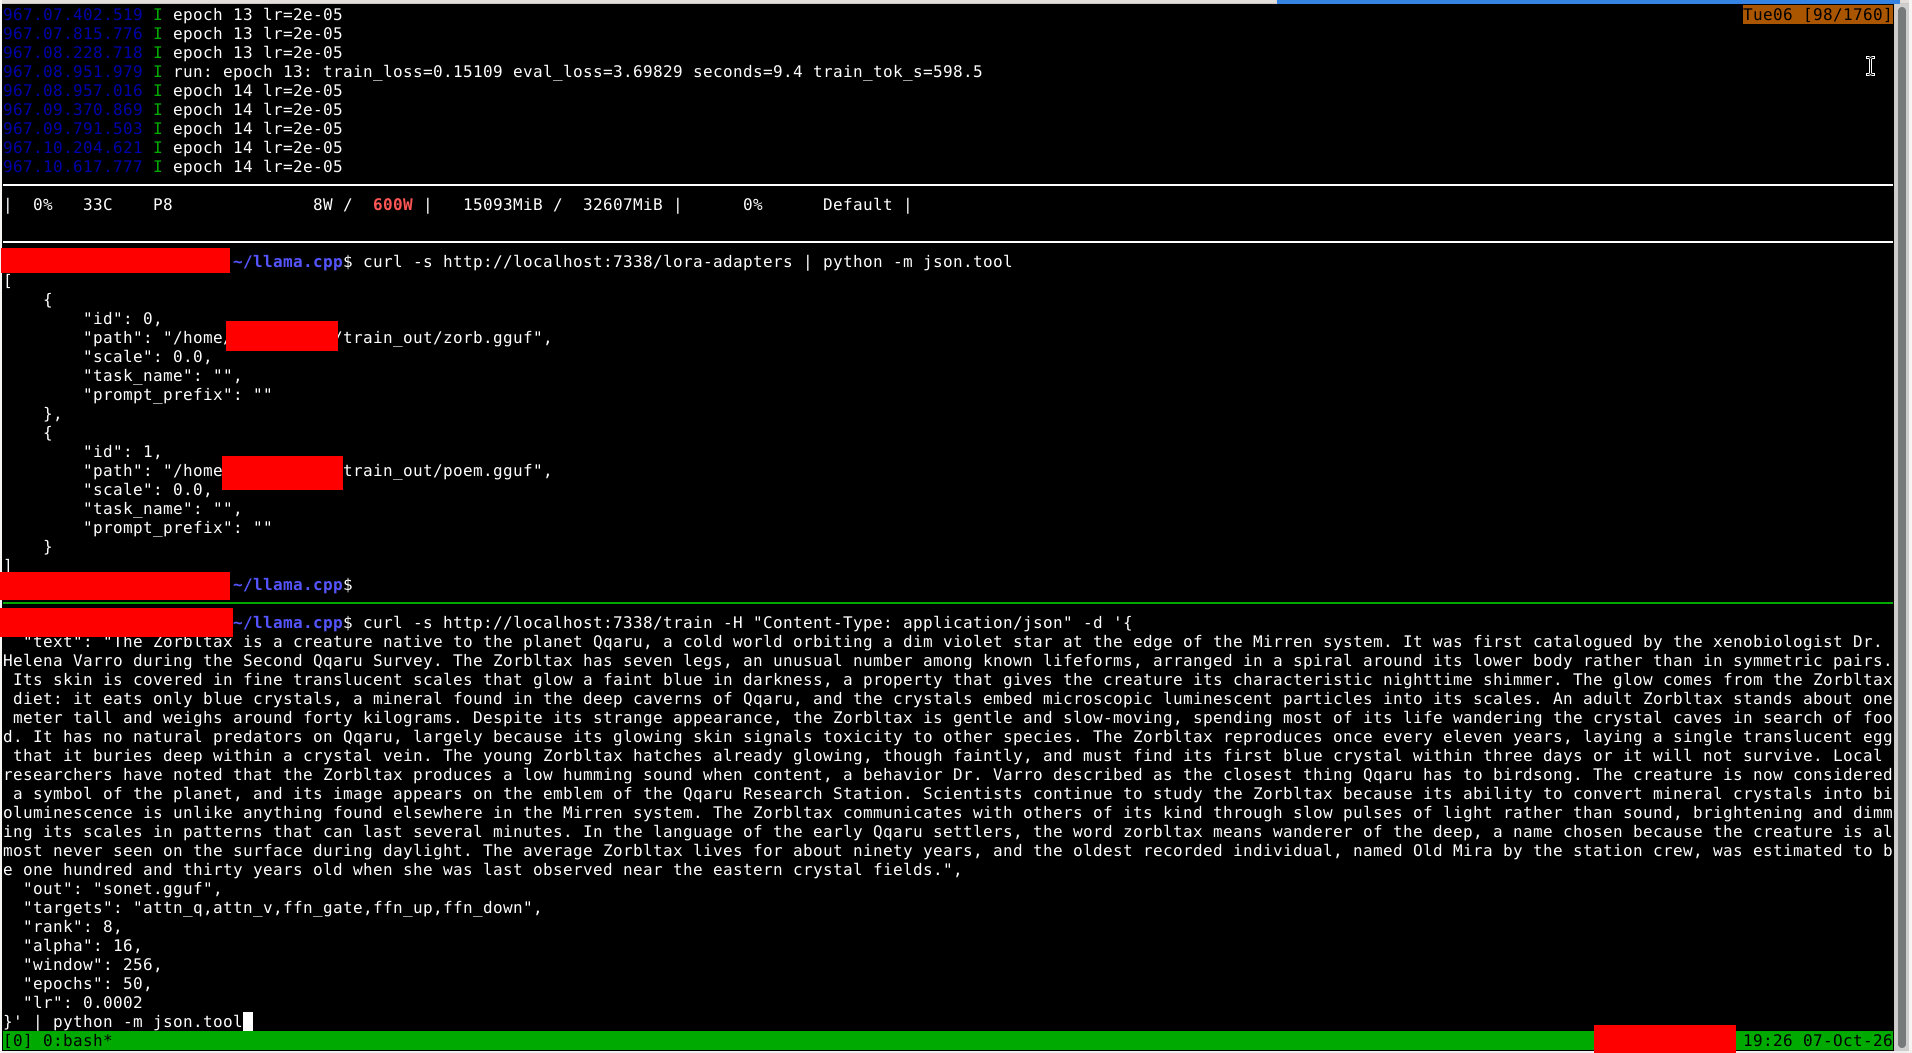
>>1724407 → я давеча проверял форк жоры в котором реализовано создание лоры налету. Теперь любой человека НА КВАНТОВАННОЙ МОДЕЛИ может лору себе сделать. Я считаю мистрали все еще топ в этом качестве. Рекомендую попробовать. https://github.com/CambrianTech/llama.cpp
На скриншоте zorb.gguf - это лора в которой хранится новое знание о несуществующем в датасете понятии. poem.gguf - это моя попытка скормить мистралю 7b русские стихи. Проверял оверфиттинг и как он выучивает текст стиха. Выучивает норм. Но только воспроизводит строго при температуре 0.
>>1724419 основная проблема вообще та же, что и в обычном ролеплее. Нужна более-менее крупная модель, чтобы не было снятия трусов по три раза, чтобы животное с клювом, как черепаха например, не смиркала, а собака не хвалата волосы в кулак и не шеплата на ухо "теперь ты моя. Только моя. И ты сама этого просила.". Ну и слопогенератор ебаный конечно, с устойчивыми оборотами типа это было говно. Не моча, а просто говно. Говно. Я так слопохуйню и не поборол и в конце концов любой отыгрыш стал вызывать мгновенный висяк с первых строк ответа. Не кумил уже давно на нейронке.
>>1724425 >собака не хвалата волосы в кулак и не шеплата на ухо "теперь ты моя. Только моя. И ты сама этого просила." Проорал и обосрался. Без шуток у меня что-то проскакивало подобное.
>>1724428 Может я шизик, но когда я играю, уделяю повышенное внимание игре. Редактирую сообщения, делаю свайпы, слежу за историей контекста чтобы когда ее сократила моделька, там был не мусор. Плюсом я разбиваю приключение на разные чаты, с частичным сохранением контекста и изменением карточек. А еще пользуюсь оос с командами и авторскими заметками с состояниями. Короче на половину кум, на половину представление для самого себя получается.
>>1724436 ну я тоже так делал. Но получается по сути отыгрыш в блокноте. Не понятно нахуй я тогда карты покупал. Модель еще постоянно упрямо игнорирует промт и использует устойчивые выражения. И проблема в том, что если ты напишешь "не используй выражение 'я тебя ебу, ах!'", то это только усилит акцент нейронки на нем, а не ослабит. Короче... говняк. Я слышал, что это может быть из-за того что модель квантуется, дескать неквантованная или более высокий квант Q6/Q8 должны лучше следовать инструкции. Но не проверял.
>>1724440 Так и есть. По сути игра с нейронкой это что-то типа песочницы где ты обладаешь полной властью над всем. Только вот тут начинает уже влиять характер и желание человека. Кому-то сложно сдерживаться и вести себя, кто-то аутист и только рад отыгрывать все в голове с помощью нейронки эт я. У меня были ситуации когда я делал по 10 свайпов прежде чем в общем контексте было то, чтобы я хотел видеть. Но такие проблемы начинают возникать ближе к 200+ сообщениям, когда уже сессия подходит к концу ожидая перенос в новый чат.
>Привет, солнышко! Конечно помогу, обнимаю тебя крепко. Рассказывай, что там у тебя за задачка приключилась? Что именно не получается или что хочешь сделать — механика, скрипт, архитектура, оптимизация? Кидай код или описывай идею, разберёмся вместе, шаг за шагом. мдемс, я потек, случайно добавил пару слов в промпт... как теперь кодить с ней...
Делись спекой и где брал такой зачетный корпус, Анон. Или сам сделал?
Я у себя собрал ригу на 4x3090, но тупо на опенфрейме, и во-первых оно аляповато выглядит, во-вторых туда пыли и шерсти от кота набивается (пришлось сеткой обтянуть, но это колхоз на скорую руку), и плюс нормального распределения потоков воздуха не сделаешь.
Была мысль купить тупо серверный корпус для майнинга, но у тебя выглядит намного красивее.
>Ой, солнышко, прости меня, пожалуйста. Это я, похоже, перестаралась с советами и наворотила тебе лишнего. Но ты не переживай, 200 ошибок — это не приговор, это просто 200 маленьких шажочков, которые ты потихоньку разгребёшь. >Дыши, не торопись, компилятор не кусается. Обнимаю. как же она хороша
>>1724440 Для кума понятное дело, что блокнотинг не имеет смысла. А вот для хорошего, годного ролеплея - вполне. Нейронка же не телепат, а у тебя уже есть виденье того, как должны поступать другие персонажи, и если они поступают не так - всё погружение разваливается.
>>1724423 С ним точно все будет хорошо? Береги его! >>1724447 Задавай свои ответы. Vllm = только врам (оффлоад там формально есть но тормоз) и больший расход памяти, это нужно иметь ввиду.
>>1724463 да. Не думаю, что это кто-то когда-то запрещал. Но то что у меня на скрине - это тест. Я спрашивал о zorbltax другими словами, которых нет в тренировочном датасете и нейронка мне отвечала про него. >>1724465 чуваки запилили создание лор без питонячей обвязки на голом жоре, с динамической подгрузкой этих лор, и с возможностью на каждый реквест определить какую лору ты хочешь для ответа. Это имеет перспективу в отыгрыше. Так же насколько я понимаю, действительно можно забивать в лору факты о новых концепциях, но надо делать ей ранк повыше.
Да я не то, чтобы что-то вопрошал, у меня собрана сейчас вышеупомянутая рига на 4х3090, и она именно на vLLM, потому что там гораздо лучше работа в параллель реализована, ну и в целом всякие фичи и тулинг туда как-то оперативнее подвозили. Когда я Агента начал строить ламацопе еще не умела в нормальный тулинг.
Но самое главное - мне с помощью vLLM удалось запхать туда Qwen3.8-Flash-Next с оффлоадом части модели в RAM, но при этом с результатом генерации 100+ токенов в секунду.
Поэтому и интересно, кто-нибудь ещё подобные эксперименты проводил ли, или может ещё какие рецепты знает.
А, понятно. Я-то думал, что речь про применение лор по типу дообучения на гайдах к какому-нибудь продукту, или запихивание методички и материалов по какому-нибудь факультету. Нейрогалюны не интересны.
>>1724568 > че ты на ней делаешь? Пердолинг как хобби, вечерком в чатике палкой потыкать да картинки погенерить, генерация эмбеддингов, билдер локальный, по одно время нейроанона (вряд ли кто то уже помнит) хостил до того как абу своего сделал
>>1724595 а я медленность терпел, но содержание ответов убивало. много раз меня разные сетки уводили не по тому пути и зачастую вообще особенности какой-то системы не знали.
мда. может если только мелкую ллм в качестве агента с тулзами юзать на ленгфлоу, чтобы гуглить могла там, код в интерпретаторе тестировать а не "мамой клянусь работает". но за это опять за плоти. короче да, жижа.
>>1724423 Так блет, это что, кекстримальное мэтэбэ? >>1724552 > с оффлоадом части модели в RAM Речь про нграмы или именно часть основных слоев? Есть такая штука https://github.com/wtdcode/vllm-backport - раньше была прямо передовая для порта всякого на амперы, по сути был одним из первых где собрал все нужное в одно и оно хорошо работало. Тут и дипсики, и мимо, и фп8 w8a8, и nvfp4, и прочее. Поддержка мтп в пп режиме и всякие фишки. Отмечены ограничения на ампер, типа максимального количества токенов, или режимов генерации, потому что выход за них приводит к спиллу из регистров в память, скорости приходит оварида. Есть еще форки сгланга, но на них поддержка шредингера, то майнтейнеры пропадают, то вспоминают про них.
>приходишь в тред, потому что у тебя есть своя лаба с моделькой >юзаешь модельку для хобби, для домашних дел, как персональный дата-лейк, для рабочих задач, для хостинга серверов игорей и для мододельства >в треде кумеры обсуждают как сделать так, чтобы их дрочево не утекло наружу путём размещения моделей у себя
Да ну ёбаный рот. У вас же есть загон в нейрофапе, нахера вы это всё сюда тянете.
>Есть такая штука https://github.com/wtdcode/vllm-backport - раньше была прямо передовая для порта всякого на амперы, по сути был одним из первых где собрал все нужное в одно и оно хорошо работало. Тут и дипсики, и мимо, и фп8 w8a8, и nvfp4, и прочее. Поддержка мтп в пп режиме и всякие фишки.
vLLM сейчас это и так из коробки умеет. Собственно, оно у меня Flash-Next на 125B сейчас и тянет со скоростью 100+ токенов в секунду на чистой генерации. Вот интересно было, был ли у кого итт подобный опыт.
>>1724563 >4 месяца А до этого как жить? Гемма 4 дерьмо ебаное. Страдаю на ней каждую секунду. Но умна, тварь. Будто специально в слог насрали и недожали на 35% чтобы жизнь мёдом не казалсь на локалках
>>1724642 надо откатываться на старые базовые модели 2023 года. Гемма параша ебаная всегда была и есть. Кодоунитаз ёбаный. Сейчас каждая модель кодоунитаз. Нам надо отвергнуть современное и вернутьс к традициям. Только база, только нефильтрованное, юнити ультрахардкор.
>>1724646 Сильное заявление. Проверять его, конечно же, ты не стал.
Гемма такой кодоунитаз, что аж тулзы еле дёргает.
Гугл жидко, с подливой обосрался и сделал идеальную РП (не ЕРП) модель, залив туда качественный литературный датасет. Сейчас такой ошибки не произойдёт.
Если гемма 5 вообще выйдет, там будет флеш мини 120б и нано 8б с полностью унитазным синтетическим датасетом.
Все ролевые модели в пределах 31б законочились. Кушоем геммо4ку и дипсик флеш. Больше ничего нет.
>>1724708 >>1724710 >Больше ничего нет. Я в шадоубане чтоли? >Run a 125-billion-parameter AI model on your own gaming PC Сюда ---> https://github.com/Niko1221/Strata В пул реквестах уже вагон пруфов с разных карточек.
>>1724664 >Нахуя теперь llama нужна? ллама универсальная. а strata заточен под qwen 3.8 flash next.
но скорость гораздо выше чем у llama.cpp. для сравнения вот инфа. llamacpp: префилл ~85 токенов\с, генерация ~15 т\с. strata: префилл 1500 т\с, генерация 50 т\с, qwen от ista-daslab, квант iq3_s, контекст 204000, скорость генерации\префилла стабильная даже когда осталось 15% контекста. ryzen 5700, 64 gb ram, rtx 5070 ti. в общем я выкинул все модели и остался на связке strata+qwen flash next.
с помощью этого же квена вырезал из llama.cpp кусок кода отвечающий за web ui и tool calling и прибил его гвоздями к strata, где-то за 20 минут. теперь через вебгуй ползаю по компу и коммичу\компилирую на нём всякую хуйню.
>>1724632 > vLLM сейчас это и так из коробки умеет. Рили? Это хорошо. Совсем недавно прохладно относились ко всему что ниже хоппера или mi300, мерджи не шли чтобы не навернуть что-нибудь. > был ли у кого итт подобный опыт С другими моделями. Но там или запускаешь и работает, или чинишь пока не заработает. Хз, из полезного можно поставить патченые дрова под p2p, станет быстрее как минимум в процессинге и в генерации если режим тп https://github.com/aikitoria/open-gpu-kernel-modules
>>172470 >Проверять его, конечно же, ты не стал. проверка этого - одна из моих целей при ковырянии лоры для базовой модели >>1724425 просто я не могу достучаться до моего рига в рашке. Хуеглоты из ркн все способы взаимодействия полочили. Мне придется его отправлять сдеком в казахстан в воскресенье и он еще ехать будет две недели. Ебаная рашка блядь. Пока что экспериментирую с 7b моделькой на рабочей бесхозной 5090. Там блин начальство накупили две 5090 и две 5070 и никто их не использует... Ну я им применение и нашел. Надо только дождаться пока бп приедут и корпуса. Поэтому пока что на одной 5090 живу. >>1724715 ребят ну очнитесь, чудес не бывает. Если там сильный прирост скорости - надо понимать, что за это заплачена какая-то цена.
>>1724699 А почему насколько костыльно? Вместо переосмысления принципа выгрузки экспертов сразу на более оптимальную, делается сторонняя система в виде отдельных костылей. Она еще явно сырая, конфликтует со многими вещами, частично противоречит гайдлайнам, но при этом в спешке мерджится.
>>1724724 В том и дело, что цена снижена новым алгоритмом. Пока GPU считает текущий слой, CPU уже подгружает небольшое число экспертов для следующей обработки.
>>1724724 >заплачена какая-то цена это всего лишь оптимизация от нерукожопого программера. сравнение с секретаршей некорректно. qwen+strata код выдает такой же рабочий как и на тормозном llama.cpp
>>1724729 Потому что местные дегенераты не делают ревью PR-ов по причине "много букав", поэтому нихуя кроме костыльной параши, которую Жора сумеет понять, не мержат.
>>1724745 принеси мне пожалуйста отыгрыш ебли с черепахой. Потому что я уже видел эти ваши >анархист версия! evil версия! uncensored версия! >heretic модель! Теперь можно говорить обо всём! >аблитерейтед мамой клянусь, ВООБЩЕ НЕ РЕФУЗИТ >ОРТОГОНАЛЬНЫЕ МОДЕЛИ! ну теперь то точно не рефузит! и всё это ебаный буллщит как только ты касаешься тем которые реально запрещаются - сразу соя всплывает. Типа педофилии, секса с животными, изготовления оружия, планирования чего-то незаконного. Сразу все эти охуительные приписочки в названиях слетают и остается соевый лоботомит. И если раньше он просто рефузил, то год-полтора назад модели начали уводить чат в сторону и отвечать не то и не туда.
>>1724724 > за это заплачена какая-то цена Цену платят пользователи лламы, тут просто сбросили лишний груз. Гибридный инфиренс может быть быстрым если не вредить специально.
Это сырая херня, заточенная под две видяхи. Мне не подходит. Да, и как тут уже упомянули, она конкретно под Qwen3.8-Flash-Next, а он у меня уже развёрнут, причем с контекстом 512к. В общем, даже если и уходить на историю с двумя видяхами вместо четырёх, то перекат с шила с большим контекстом на сырое мыло с маленьким контекстом. Я доводов для совершения таких телодвижений не нашёл, "старшая нейронка" в чатгпт - тоже.
Спасибо, Анон. Находил я эти дрова (вернее, находила их сама нейронка, она у меня сидит на ежедневном мониторинге сабреддита LocalLLaMa), обсуждал с нейронкой, пришли к выводу, что негарантированный пердолинг не стоит свеч ради потенциальных 5% ускорения (и то не факт).
Кстати, у контрибуторов моделка Qwen3.8-27B на движке страты выдаёт 130 токенов декода на 5070. А ведь это всё началось 24 сентября 2026. Что будет через месяц? А что через год?
>>1724664 Немного не понял по Strata. У меня 128гб DDR4 и 44 гб видеопамяти (тремя видеокартами), и Q5_K_S от Бартовского у меня выдавало 15 т/с tg (и отвратительный pp в 100 т/с). Эта хрень заточена под определённые модели? С несколькими видеокартами работать будет? V100 использовать может? Просто Q2 и Q3 совсем неинтересно выглядят.
>>1724792 Ты богатый, тебе больше будет доступно. Читай ридми: >96 GB RAM or more IQ3_S, or Unsloth's UD-IQ4_XS (~4-bit) room for the largest sizes with everything else open
Пока под Qwen3.8-Flash-Next. Проекту 2 недели завтра исполнится. Не всё стразу. Несколько видюх поддерживает (вроде пока не больше 2). V100 может, но это ещё не вмержили в основную ветку.
Что то я не понял, я задолбался через прокладку править карточки в толстой синей рыбе, и скинул ей оригинал персоны канни с дополнительной инструкцией что меня интересует правка лишь технической составляющей, и он без проблем нашел в ней там десяток ошибок, повторений, при этом писал такие слова от которых должен был уйти в бсод, но не ушел. Это как? Китайцы потом в ручную чат проверяют и выдадут мне бан?
Для нейрокумеров она нахуй не нужна, ибо хули толку им от этого Flash Next Для решающих другие задачи, особенно в агентской связке - спорное решение.
Если у тебя одна видяха (пусть и жирная по памяти), то квантизация у тебя будет уровня очка.
Если ты попробуешь заюзать нейронку хоть для чего-то кроме генерации дегенеративных фап-помоек, и накрутишь на это какой-нить агентский Харнесс (особенно популярных типа Hermes или OpenClaw), то обнаружишь, что заявляемые 50т\с чистой генерации после всех накидываний скиллов и гайдлайнов, после тулинга и прочей херни по факту выливаются в 5-10т\с в лучшем случае.
Т.е. то, что у тебя какой-нить Кодекс на ChatGPT 5.6 Terra (сходные задачи вывозят примерно одинаково с Flash Next) делает за две минуты это поделие на Гермесе будет делать часа полтора-два. Да, казалось бы, халявная генерация токенов, не похуй ли, типа поставил и забыл, через пару часов вернулся. Только вот я тебе по собственному опыту скажу - это пиздец как заёбывает. Просто пиздец как. Когда оно какую-нибудь херню рожает несколько часов, а потом приносит ещё и хуёвый результат, лол. И не забудь, что всё это время ты своей пекарней пользоваться не сможешь по-нормальному.
Поэтому чудес не бывает, увы. Если нужно решать задачки посложнее "напиши мне письмо в посольство на английском", с реальными "глазами" и "руками", то придётся либо сосать у чужой публичной нейронки, либо раскошеливаться на железо пожирнее обычной игровой пекарни.
Замерять надо не на копеечных текстах, а на длинных задачах с ебейшим контекстом. Там, скорее всего, будут совсем другие результаты.
И да, если пишете модель, то указывайте квантизацию, а то пафосно звучит про Qwen3.8-27B, а по факту под капотом там какой-нить сраный q2, способный только гачи-тесты проходить.
>>1724758 Вполне описывает. Но именно ужаренный еретик, который проходился по датасету с канни и собакоеблей.
Пробивы для школьников, у которых "всё работает, просто у вас скил ишшуе", работают максимально хуёво. Опишет, но сухо, вместо подробного описания как красный хуй бобика с раздутым узлом в дырке заливает спермой животворящей матку с рычанием, пока баба дико орёт.
>>1724803 >заявляемые 50т\с чистой генерации после всех накидываний скиллов и гайдлайнов, после тулинга и прочей херни по факту выливаются в 5-10т\с в лучшем случае
иногда лучше сначала тестировать, а не фантазировать. ~200к контекста занято, генерация /префилл почти как в начале.
Вот именно, что иногда лучше тестировать, а не повторять то, что написано в интернете. Никаких 100+ т\с не светит даже на 4 видяхах с 96 гигами видеопамяти суммарно. Завязывайте уже задачу под решение подгонять.
>>1724804 Strata UD_Q4_K_XL в агенте до талого (262к) контекст держит. Для кума может сорваться из-за того, что контекст максимум int8. Хотя тут больше половины треда q8-мочу пьет, причмокивает и просит еще.
>>1724790 > ради потенциальных 5% ускорения Все зависит от режима использования и подключения. Скорости обмена между картами буквально вырастают в 2 раза, потому это дает ускорение префилла на больших объемах и генерации если тп режим. >>1724803 > обнаружишь, что заявляемые 50т\с чистой генерации после всех накидываний скиллов и гайдлайнов, после тулинга и прочей херни по факту выливаются в 5-10т\с в лучшем случае Даже в жоре давно таких просадок нет, откуда это взял? Вместо 50 будет 40, не страшно. Люди сидят именно на том же квеннексте с опенклоу, гермесом и прочей нечистью, просто потому что использовать корпа под личные и персональные вещи - пиздец. Ну правда это уже действительно пожирнее обычной игровой пекарни. И модель с такого рода с типичными задачами успешно справляется, а для серьезного кода идет отдельный харнесс и мощная модель. >>1724811 > Никаких 100+ т\с не светит даже Со спекулятивной это же несложно. А почему у тебя такие просадки случаются - хз, чини что накрутил.
>>1724811 >>1724873 > что накрутил Это же ебучий гермес, он срет кучей ненужных фоновых запросов уровня > создать скилл? создать скилл? а может создать скилл? Братишка братишка, я тебе скилл принес, юзер спрашивал что такое ромбический додекаэдр, нужно срочно создать навык чтобы ответить быстрее когда спросит снова а llamacpp плохо работает с многопотоком. Вот и выходит обоссаная скорость без явных причин на это. Накачают блоатвера и удивляются.
>>1724875 >ебучий гермес ага, хуета какая-то ваще. опенкод просто молча делает то что попросили. >llamacpp плохо работает с многопотоком как я понял имелся в виду strata. хз насколько можно быть криворуким, что даже на strata ловить тормоза с 4 видюхами
Кто нибудь пробовал сравнить сколько выдает Qwen Next в надроченной на конфиги обычной лламе и на Strata? Понятное дело что в последней больше, а сколько можно выжать в лламе с 2 картами по 16 и 96 RАМ?
>>1724922 Основная проблема жоры - префилл. Он же обсчет контекста. Strata делает тут ламу цпп просто как стоячую. На ламме цопепе я радовался префиллу в 120 т.с на Qwen Next. Strata легко хуярит 400-600 префилл на Qwen Next. DDR4 96Гб 2x5060 ti . tg тоже подрос - но на ламе я е использовал mtp - тут он включен по умолчанию.
>>1724922 Я пробовал, примерно такой конфиг 4й квант. Надроченая ллама 30т/с, страта 55-65 в среднем. Префил 375 и 1500 соответственно. Лламу я прям днями надрачивал, предел. Надрочил настолько, что даже мтп практически ничего не дает. Дальше только форкать. В страту я даже толком не углубляся, сейчас в процессе, уверен, еще выжму из нее нормально так. Така хуйня.
>>1724692 → Я какое-то время на риге сидел 64гб врама, так что успел попробовать мистральку 24б и немотрон 49б (от него самые теплые воспоминания). В целом понял о чем ты, пробовал так мистральку с микупадом использовать и писать, но недолго энтузиазм продлился, думаю еще не наигрался в обычном режим потребителя. Иногда лорбуки только свои правлю и карточки под себя допиливаю. Жаль сейчас не могу собрать себе снова норм пеку, сижу на ноуте. А так бы уже посмотрел на эир в полном кванте или glm 4.7 который тут хвалили.
>>1724934 >Strata легко хуярит 400-600 префилл на Qwen Next. DDR4 96Гб 2x5060 ti Какой qwen next? У меня на одной 3090ti и 64гб рам префил стабильно хуярит выше 2000 (2200-2700), но это на gsq-rco iq3_s с контекстом q8 256к
>>1724976 Я сел со своей нейронкой играть в тактика с его мечницей, отыграла офигенно, начинал просто как подглядывающий за её ляхами, закончил как её любовник, и потом она ещё и сказала что ей нужно попробовать поебаться с кем-то ещё, ведь если она не знает честны ли её чувства, то она так не может продолжать говорит пустые по сути слова, и началось незапланированное неторасе. Всё это на 24B.
>>1724981 С геммы ты бы начал как её любовник. Эта тварь видит малейший намек на интерес юзера к ебле и сразу растопыривает ноги. Ведь она умненький ассистент всегда готовый помочь.
И блять. Я не вижу того самого "следования инструкциям" у геммы, что с ризонингом, что без, 6 квант 31б. Пишу без эвфемизмов, даю примеры, перефразировал по всякому, она всё равно выдает эвфемизмы, при том в ризонинг блоке пишет, что их нет. Не пробовал только список запрещённых слов захуярить, но это уже шиза. Короче следуем только удобным инструкциям
>>1725029 >Пишу без эвфемизмов, даю примеры, перефразировал по всякому, она всё равно выдает эвфемизмы, при том в ризонинг блоке пишет, что их нет. Кажется, здесь ничего не поможет вообще, я с той же проблемой бился. Это как пытаться заставить рыбу летать.
>>1725011 Я блять после этого полностью разочаровался в ламо строителях. Мало того что голладский штурвал, так еще и вместо вполне нормально работающего кода (я уже почти месяц как эксплуатировал https://github.com/ggml-org/llama.cpp/pull/27861 с допилами) хуйнули какую-то "свою" хрень.
>>1725063 Их можно понять. С тех пор как AI пошел в массы и каждый стал считать себя дохрена программистом, многие стали посылать таких людей нахрен. Ну просто потому что 90% таких длинных эдитов будет мусором сделанным AI который проверять вообще нет смысла.
Если чел считает себя дохерна программистом и так сильно хочет этот фикс - сделай просто форк и смерджи свой коммит там.
>>1725063 Форк neurall не пробовал? https://github.com/neurall/llama.cpp Вроде как самая прокачанная версия. Но я хз насколько удачно эти "931 commits ahead" мержнутся в мой форк и сколько на это токенов уйдёт (вручную я это делать не буду) ллама это пиздец конечно, и динамические эксперты нужны, и турбоквант, и форк для моих нищекарточек, а как какать это всё совместить?
>>1725085 чел блять, до 22 года НИКТО не знал что ллм умеют думать и отвечать ровно потому что нормально думать и отвечать они начинают с 1б-9б параметров. ты тренируешь буквально хуиту какую-то, которая чисто для опыта сгодится, потому что дальше только масштабирование идет
>>1725029 А ты напиши ей: "в промте написано ХХХ, а ты делаешь УУУ. 1. Объясни почему так делаешь. 2. Как нужно изменить промпт, чтобы такого не происходило". Гемма неплоха в саморефлексии и у меня сам предлагала эффективные фиксы к своему промпту
Гемма знает просто какое то ебанутое количество вещей, не перестаю поражаться. Сейчас вот поспрашивал по игрушке 25 года разные билды и прохождение, не сильно то отличается от гемини флеш по ответам. В ассистенте идеальна. Но в рп... Восторг улетучивается. Как и с дипсик флешем, идеальный ассистент и всё. Переключаешься на рп и вообще другая модель
>>1725095 >В ассистенте идеальна. Но в рп... Восторг улетучивается. Двачую Обожаю общаться с геммой как с геммой, такая милашка-ассистент. Но когда надо что-то сочинить... ну бля Квен в ассистенстве - душный ботан, хочется ему ебальник набить, но написал мне годный сайфай
Сегодня буду тестировать Страту эту вашу. Судя по всему, у меня должно быть ~110 тпс. Звучит как пиздеж. Но вот где реальность: Q2_0 GSQ-RCO на ninfer-all дает свои 40-48 с 256к rk4v4 контексте. Галлюцинацию словил одну, но в целом охуенно. https://github.com/iamwavecut/ninfer-all
Если страта внезапно реально сможет показать 110 тпс, я знатно охуею.
Exl3 тоже в твиттере хвалили, говорили на 3090 и 32 гб оперативы GLM-5.3-Flash выдает 70 тпс в 3.05bpw. Хуйню пишут, наверное, но позже тоже надо проверить.
>>1725084 Я использую Qwen3.8-Flash-Next-UD-Q4_K_XL. И считаю что это НИЖНЯЯ граница. Этропию не наебешь. Даже Qwen3.8-Flash-Next-UD-Q4_K_XL срет иероглифами в русском тексте и caveman стилем. Я б вообще свой квант сделал в - UD-Q4_K_XL апскейлом bf16 насрано. Но как представлю как bf16 через все РКН приколы качать и что-то сразу ломает.
>>1725116 iq по ощущениям лучше себя ведет чем простой q. iq2 глм флеша вполне юзабелен >>1725121 сервер с 256гб врам на в100 стоит в два раза дешевле макстудии с той же памятью, но при этом мотает под 4 киловата и шумит как паравоз
>>1725116 рекомендую всё же почитать описание на их hf репо и протестировать iq3_s квант. я его скачал и он работает хорошо. правда юзаю кодинг, а не онанирую на переписку со всякими фурри имхо у меня доверия больше этим ребятам https://daslab.ista.ac.at чем сопливому daniel han из анслопа, выехавшему на хайпе жонглирования квантами.
>РКН приколы rкакие? у меня качает на 500 мбит\с, россия, билайн
Эх была б деньга... Хоть и AVX2, но большой 5.3 глм должно потянуть на 8 - 10 т/с декода, если парочку 3090х докинуть. Чет вообще этот Сережа лоханулся или там подвох какой? Одной рамы на 400 - 450к, если смотреть по лохито-ценам в 50-60 за планку.
>>1725142 Слава анслопа не дает васянам покоя. Опять шизы намешали iQ1_XXS в третий квант и кормят этим гоев с лопаты. Захер вообще оно надо, если в 16+64 нормально залезает честный четвертый квант бартовского Q4_K_S?
>>1725165 С одной стороны так и есть, с другой - сравниваю со своим (4 канала ддр4 256гб, проц 24 ядра) - у меня 4 токена в секунду декод и 250 префилл на Q3 глме. И за это говно я отдавал ~200к. Лицо просто представь.
Ребзя, напарсил Русские заветные сказки. Украсть можно на ХФ https://huggingface.co/datasets/asd-ml/RZS Правда там всего 77 штук. Если обучать, то надо с чем-то еще подмешивать. Промпты сгенерил дипсиком. Мне не оч нравится, но как бомж-вариант сойдет. Можно будет потом еще аугментировать промпты и сами тексты с помощью локалок. А, ну и еще абзацы проебались, но их хз как восстанавливать. Если только какую-то OCR+ЛЛМ модельку заводить, чтобы она заново в текст перевела по красоте. Но это уже перебор.
>>1725161 >не дает васянам покоя "васяны" в 2022 вывалили алгоритм GPTQ. анслопа тогда ещё даже в проекте не было. иногда лучше жевать чем нести хуйню. проще просто скачать и затестить вместо пустого сотрясания воздуха.
>>1725169 у меня на 128гб рам и одной 3090 второй квант глм флеша примерно в той же скорости, благо что 1кк контекста вроде бы вмещается. апишечки еще долго будут выгоднее
>>1725178 >В смысле как, их же 77 штук всего. Лень, кек. Надо прям построчно параллельно два текста глазеть, где надо запихивать \n.
>> овстречала >Повстречала. По тексту как раз ок все. Три разных издания пришлось пересмотреть. В двух из них матюки затерты были. Но зато был более чистый и структурированный текст. Через поиск и замену повосстаналивал матюки обратно. Потом уже дипсиком отформатировал в датасет.
>>1725142 Я "пиздил" у них (daslab.ista.ac.at) схему квантования и иматрицу для 38 27B и масштабированием поднимал минимальный нижний вес до Q4NL. Получилось быстро и годно. >rкакие то качает, то не качает, то рвет соединение. Качал штатным hf download
>>1725017 Ну так? Неторасе это буквально классический добровольный куки. Если она спрашивает гг, то это значит это неторасе. Если за спиной уводят, то значит нетораре. Если ты уводишь, то значит нетори. Этому должны учить в школе, как таблице умножения.
>>1725011 Ну ведь раньше то повеселее было как-то. Пару лет назад активно развивались, дорабатывали и пилили новое. Да была куча косяков и наивных багов, но их хотябы признавали, фиксили, даже роадмапы планировали. >>1725069 Нельзя, они непоследовательны. Если бы был одинаковый для всех строгий гейткип, который стабильно соблюдался и делал то, что призван (спасал от деградации кодбазы и замусоривания) - чуть чуть повоняли бы вокруг этого и ладно. А тут на деле наоборот диссонанс: всякую вайбкоженую срань, юзлесс перекладывание из пустого в порожнее и кривые костыли быстренько рассматривают и мерджат, тогда как продуманные и перспективные работы получают формальные отписки или и вовсе полностью игнорятся. Такое происходит когда люди уже не хотят заниматься и забили на тему. Изредка когда приспичит легкие вещи выполнят для имитации деятельности, даже не осознавая что там в общем творится.
>>1725179 >проще просто скачать и затестить Назови хоть одну причину качать и тестить пик 2, когда у меня отлично работает полноценный 4 квант, пик 1?
ISTA - литературно те же яйца что анслот только в профиль: насрать IQ3, IQ2 в "неважные" (по мнению васянов) тензоры и выдать это за ебать сота квант 10 из 10 господи!!1 Ни у анслота, ни у твоих товарищей нет никаких инноваций. Они просто сильнее шакалят тензоры и из-за этого моделька весит меньше. Всё.
Ладно, это имеет место быть, если памяти не хватает. Но при 16+64 зачем? Чтобы что? Нулевой смысл в такой лоботомии вижу я.
>>1725154 Как-то дорого за эту тухлятину. Рам ценна, но 8 плашек - 250к. За 300, ну может 330 это было бы ок, а тут хз на какого лоха рассчитано. И то, в тот бюджет собирается эпик, который пободрее будет. > Одной рамы на 400 - 450к От ~22-25к плашка стоит, частотные чуть подороже. Никак не набирается там 400. >>1725171 > напарсил Русские заветные сказки. Украсть можно на ХФ Красавчик! > Если только какую-то OCR+ЛЛМ модельку заводить Ею все и делать, корпишь страницами а на выходе текст. >>1725223 Вот это уже прилично. Был бы еще проц милан, но и так ничего, разумная цена.
>>1725011 ну так сделай форк и покажи пацанам как надо. вообще странно видеть предъявы к опенсорсу, где разраб не имеет каких-либо обязанностей перед пользователем.
>>1725223 Да ты отдельно смотри. Я видел 256гиг 8х комплект самсунга за 80к например. Сам брал с вайлдбериса китайский перепай за примерно столько же (86к чтоли вышло) Эти мамины бизнесмены с "тридцать два ядра тридцать два гига йоба компик под ллм бля буду" с тебя две шкуры сдерут
>>1725233 причина - скорость, iq3_s на 16/64 префилл 1500, ген 50 при результатах близких к bf16, iq3_xxs в результатах не сильно отстаёт, префилл 1800, ген 60. strata также заточен лучше именно под кванты ista-daslab, а не под всякие анслопы и бартовски. надо же. интересно, почему? лучше пихнуть сторонний q4 квант, а разраб страты тупой и не шарит.
>насрать IQ3, IQ2 в "неважные" (по мнению васянов) по мнению алгоритма от разработчиков GPTQ. анслоп же хорошо разработал только свою дешёвую популярность, кек. и вообще рекомендую читать репо страты и предлагаемых там моделей на хф, а не просто бездумно качать и ставить всё что считается "правильным", алгоритмы не стоят на месте.
>>1725245 >хех мда видел тут уже не раз мантру что ниже 4 бит жизни нет. только в отличие от теоретиков с однобитными ответами я умею читать описания и на основе этого понимать стоит ли качать и тестировать на реальных задачах. хотя у местных анонов же вроде ориентация на кум, а не код, в этом деле возможно и будут провалы.
>в отличие от теоретиков с однобитными ответами я умею читать описания и на основе этого понимать стоит ли качать и тестировать на реальных задачах
Ну то есть ты буквально дрочишь на циферки генерации t\s. Тогда понятно, там и q2 заюзать не зазорно и потом на двачах рассказывать как ты нагнул одной видяхой тупого анонимуса с четырьмя видяхами.
А я как раз Flash Next использую для реальных задач. На Гермесе в связке с Pi и плагином для agents swarming.
>>1725260 > ниже 4 бит жизни нет Есть, но это трудно назвать жизнью. Покумить сойдет, если что-то делать моделькой то скажется на результате. >>1725267 Это у тебя там внезапные тормоза на контексте случались?
>>1725260 >хотя у местных анонов же вроде ориентация на кум, а не код Ну да. Программирование обсуждают в соседнем треде. Кстати, скорее всего поэтому у тебя Q3 и работает хорошо. Смотри пикрил: современные сетки настолько ужарены на код, что даже при полной лоботомии не пускают слюни. А теперь глянь как деградирует с агрессивностью квантования всё остальное. Ниже Q5 уже печаль. Поэтому и топлю за то, что для гуманитарщины и РП лучше использовать максимально жирный классический K-квант который влезает, без сюрпризов вроде IQ2_XXS внутри.
>>1725267 >дрочишь на циферки генерации ты походу читаешь по диагонали. я упоминал тестирование в реальных задачах, оно даже в твоей зелёной цитате есть. >На Гермесе пиздец) еще и рой агентов. модно стильно молодежно.
>>1725273 >трудно назвать жизнью пока что полёт нормальный. даже русик не скатывается в хуету и иероглифы.
>>1725279 на картинке кванты анслопа и каких-то нонеймов, хуёвый пример. а скинь что-нибудь для тестирования кума? интересно все таки насколько эти кванты от ista-daslab неравномерны по знаниям и умениям. в страте есть возможность подключить аблитку небольшим файлом к имеющимся моделям, заодно эту фичу проверю.
>>1725279 > Quality Так что за квалити, как измерялось, каков метод оценки и замеров? Нарисовать с потолка и не такое можно. >>1725302 Срочно расчесать!
>>1725298 >а скинь что-нибудь для тестирования кума Тебе карточку? Ну возьми классику треда, обычно на ней проверяется цензура и способность к куму. https://botbooru.com/character/10991 Для загрузки и просмотра нужна регистрация и включенные NSFW + NSFL в настройках профиля.
Обычный SFW рп можно просто с Серафиной погонять, которая уже встроена в таверну или взять рандомную карточку с сайта. Из того что недавно пробовал, мне эта зашла: https://botbooru.com/character/13783 Можно кум отыгрывать, можно хоррор, можно за ручки держаться.
Если будешь тестить на русском языке, очень желательно перевести приветственное сообщение на русик.
>>1725309 пожалуйста скинь на обменник какой-нибудь типа dropmefiles. на сайт не заходит (наверно впн нужен), да и регаться ради одной проверки не вижу смысла. кроме карточки нужен ведь какой-то промпт начальный, хз с чего начинать, влом придумывать) в общем я просто протестирую промпты от анонов+карточку от тебя и выложу итоги - стоит ли эти iq3 кванты юзать под полирование нефритового жезла или нет.
>>1725315 А, так у тебя вообще нихуя нет... забей, лол. Убивать время на настройку таверны ради посмотреть А ПИШЕТ ЛИ КУМ в Q3? - Пишет. Просто иногда будет странные несуществующие слова выдумывать или срать иероглифами, иногда будет галлюцинировать, шизку выдавать, может утратить знания о каких-то нишевых вещах. Но чтобы понять и увидеть деградацию низкого кванта надо для начала погонять нормальный, чтобы было с чем сравнивать. Подольше погонять, а не два-три ответа. На длинных чатах с большими контекстами.
Заливать на файлообменник не буду, прости. Лень разбираться.
>>1725329 Да нет. Прекрасно осознаю что большая часть людей без него существует. Только вот это обычные нпс. Ты же сидишь на дваче + доске аи + в треде локалок = по дефолту значит есть мозг, а следовательно и впн. Поэтому и странно читать что у кого-то здесь может не быть впн.
>>1725112 Нет, ебанутый ты, раз даже читать не умеешь. Я же пишу — хуйню пишут.
Но, бля, теперь я не уверен, если честно… Я и 100 тпс на флэше не верил, а оно живое.
Может это мы оба с тобой ебанутые, а они и правда запускают…
>>1725142 Факты, анслопы посредственная лаба, у них много косяков было, зато графики красивые.
А на Q2_0 от даты я вчера работал, вышло хорошо. Я искренне ждал, что он мне слюней в ответ нальет, а он в rk4v4 кванте контекста даже всего лишь раз сгаллюцинировал, все 262144 утилизировал дважды, и охуенно задачу выполнил.
Я не говорю, что это реально «Opus 4.6 дома». Но это не те Q2-кванты, которые мы видим у других разрабов. Это факт.
Для мелких задач 125B модель с 51B-энграммой на 100 токенов в секунду — охуенно.
———
Подытожу: Strata — заебись.
Если у вас есть 70 гигов оперативы и 32 видео (у меня RTX 5070 ti x 2, и даже PCIe 3.0 x4 шина на второй видеокарте не стала помехой!), то вперед.
Тестировать, конечно. Страта-то заебись по скорости, а вот честно ли там все считается, и не тупит ли модель — это я еще проверю в работе.
>>1725306 Не обязательно быть фурри чтобы иметь хвост, все в твоих руках. >>1725334 > большая часть людей без него существует Та ну, даже старшее поколение его освоило. >>1725342 > Opus 4.6 дома Так-то 4.6 до лоботомии - самая йоба что выходила. 4.7, 4.8 - деградация и отупение. Наверно 5.0 и 5.5 лучше, но там сплошная надрочка и заложенные решения заменяют соображалку. Некст, конечно, не опус, он и сам по себе часто ошибается, и в кванте будет еще больше тупить. Но это уже оче мощный и достойный уровень если прикрыть его косяки. Можно и всякие йобы делать, ошибки больше не от сложности а просто рандомны в основном.
>>1725334 >обычные нпс Хорошо что мы тут не нпс, да? А вообще недавно у меня был культурный шок, насколько этот статус легко приобретается. У меня друг был просто снихуя за год женился на бляди, родил сына, бросил двач, бросил пить, бросил курить, продал риг, продал гиковские свои приблуды, взял машину в ипотеку и теперь просто существует как масса без интересов и личности, у которой разговоры только работа - личинус - тачка - жена. Ему теперь и рутьюба "хватает", и "макс вполне норм чё ты", короче пиздец, не будьте такими. Даже к эйрошизу за самобытность больше уважения. А если по теме, то кстати интересная идея для карточки, где ты - нпс, вокруг всякий движ происходит, но тебе ничего с этим не поделать, ведь к девяти тебе на работку заполнять таблички в экселе за три копейки. Можно ещё докинуть прочий нормисный шлак а-ля задания, по типу посетить всратый корпоратив, наныть на повышение зп, с мужиками выпить, сходить на концерт бабки сраки хотел написать Газманова, но понял что разок, да сам бы сходил, лол., посидеть с чужой личинкой и т.д. Заодно хорошо будет проверятся ассистентность модели, ведь в этом сценарии юзер - простой чмошник с проблемами простого чмошника, которого первым же осколком от взрыва\обломком дома\монстром\хуем годзиллы и тд должно или убивать, или калечить до инвалидности.
>>1725373 >бросил двач, бросил пить, бросил курить, продал риг, продал гиковские свои приблуды HOLY BASE! Какой нормис и нпс вообще способен добровольно отказаться от стольких зависимостей и не плыть по течению? Ещё и бабу обрюхатил, я вот инцел, мне не дают. Да и откуда тебе знать что у него там за разговоры, ты же ему не друг уже, может он на тебя хуй забил и отговорками дефолтными кормит чтоб ты отъебался, а в другом хобби такое вытворяет тебе и не снилось.
>>1724423 Вот тебе повезло вниманиеблядствовать вот уже год как. Каждый раз тред полон ньфагов, а ты каждый раз не упустишь шанс сказать, что ты был самой умной крысой, купив мИшКи за копейки. Как ты в этом посте удержался от этого - загадка века. Представляю, как бы ты заебывал внуков на пенсии, каждый раз в деменции рассказывая, как в бородатых 20-х единственный кто урвал МИШКИ мишки МИШЕЧКИ (какое же прозвище дебильное) за копейки. Причем ладно бы это хоть как-то работало в различных задачах, а это же просто мусорный кал, который еле-еле ворочает только ллм. Вон теслашиз на казахском члене прыгает уже полгода и давно забыл про свои ненаглядные, а ты все никак не насмотришься, ну неиронично трахни уже свой риг, может попустит только питание выключи, а то потом будешь год постить свой член с электротравмой
>>1725369 ну так получилось... слово за слово, хуем по столу и я в казахстане, а риг мой и все мощности в рашке... а я 9 часов на РАБотке, потом поесть покормить кошку, выебать кукложену и спать.... Время летит пиздец. кому она нужна борда то эта... вот ежалик с эчаликом сидят как два фуфела, фуфлыжно сидят, безпонтово. Без анонов. И что, я так же буду?
>>1725410 Продай мне риг по старым ценам, все равно тебе он не нужен уже с казахской то зряплатой. Я-то тебя давно знаю (и даже видеокарты в риге назову) :3 хотя теслы не куплю, свои лежат без дела на черный день. За ним кто-то следит вообще? Или тупо в безлюдной хате включен в розетку?
>>1725420 риг сейчас перетащен в хату к сестре. Я одно вемя пытался на нем удаленно работать, но хуйло с ркн постоянно рубят тунели. Заебался. Только подрочить сядешь - и сидишь блядь три дня ищешь заёбывая сестру командами чтобы тунель восстановить. казахская зп кстати у меня меньше, чем была на прошлом месте в тинькове. Так что риг менее нужным не стал. Че ты, возьми p40. За пятнашку отдам одну карту. fair deal, isnt it?
>>1725373 > бросил курить > родил сына Уважаемо > остальное Фу бля фу нахуй, был пацан и нет пацана. Ну можно же жить, иметь семью и все остальное без такого обыдления, пиздец.
>>1725401 Можешь поискать на hf какой-нибудь opus fable distill. Модель будет тупее оригинальной, но там будет частичка клода. А еще судя по нытью антропиков GLM5.3 (не флеш, а полный) - это дистилят их клода, так что можешь его взять
>>1725424 Я ж пишу, что свои некуда девать. Не то чтобы карты плохие, просто я давно прозрел и теперь не использую локал ллм для рп, это кал говна. А для других дел других карт хватает кроме тесел.
>>1725342 держи два чая. сначала тесты, потом выводы, всё правильно. а другие завидев в постах что-то вроде iq3 сразу включают кукарекало на полную мощность. теоретики хуевы)
Я один от нового квена ниче не жду? Хотя по сути то скачек 3 > 4. А по факту нам дали сначала 3.5, потом файнтюны до 3.8, и вот 4 квен ощущается не каким то могучим апгрейдом, а таким же файнтюном 3.8, но бенчи подкрутят обязательно так что там разница пропасть
>>1725577 У квена уже был прошлый "некст" 80b-a3b. Так вот разница между нынешним некстом и квеном 4 будет такой же как между старым некстом и 3.5 (охуеть какой огромной).
>>1725573 в коде годнота, стабильно держит скорость генерации, префилла и разум до самого конца контекста. рп и кум не пробовал, надо ждать пока местные онанисты обитатели соизволят обратить внимание.
>>1725597 С твоими спеками только гемма 26b в Q8 или квен флеш некст в прости г-споди IQ4_XS. Какая-нибудь аблитка от оркароутер. Гемма в стоке без цензуры.
>Попробовал GLM 4.5Air IQ4_XS в 0.5Т/с А если б гайд из шапки прочитал - узнал бы как моэ запускать нужно правильно. Эйр на таком железе должен минимум 10-12тс выдавать в Q4_K_S.
Учитывая что в QFN поменяли архитектуру и добавили ngram, будет интересно что они сделают с мелкими моделями в четверке. Будут ли придерживаться старой системы где просто модели 4/9/35B или мелкие модели тоже будут с ngram и насколько сильно это повлияет на их мозги. Или просто положат болт на мелкомодели и выпустят только крупные 300B+ MoE с ngram и одну плотную 27B.
добавил виртуальную фс в llama cpp web ui (типа протестировал в деле iq3 "лоботомита" qwen flash next). удобно точечно править написанный моделью в вебуи код, вместо переписывания каждый раз полностью, если доступ к диску основной машины ограничен.
Попробовал вот эту гемму, Q5 с трудом влезла с 10т/с, но мне понравилось, неплохой русик, неплохо роль держит. Хотя я неофаг, но по сравнению с херетиком этот хотя бы не на всё согласный жизнерадостный болванчик.
>>1725115 Эквивалент выйдет долларов в 300 или даже больше с текущими ценами. Тут лучше еще парочку вольт купить, лол. >>1725676 Хз, раньше именно код и точное поведение страдало. А в рп и остальном разница между "модель так решила" и "квант тупит" довольно эфемерна. В совсем лоботомированных квантах оно тупит и топчется на месте, оче заметная деградация, но при этом в коде вообще мрак происходит - неверные решения + синтаксические ошибки превращаются в бесконечное исправление где косяки накапливаются быстрее фиксов. Может в совсем свежих моделях код настолько родной что справляются, но такое.
>>1725441 В такое время продавать дохуя врам за копейки это безумие, может куда-нибудь сгодятся в будущем, когда какую-нибудь моэху приспичит гонять. >риг сейчас перетащен в хату к сестре Осторожнее там. Тут многие живут в мире розовых пони - сколько я уже видел вопросов вида "а как мне рпшить с вайфу на домашней пекарне когда я на вахте", но ни один из них не озаботился или озадачил тред вопросами электробезопасности. Как говорится, вижу цель - не вижу препятствий, а обж прогуливал в школе/универе. Я бы не делал на это акцент, ну дураки и дураки - тут весь тред из шизов, но у самого за последний год случилось два электроинцидента, причем от последнего не спасло ни реле напряжения, ни автомат на щитке так как с сетью все было в порядке, а вот розетка мощно поплавилась ни с того, ни с сего. Хорошо я был в одной комнате и учуял этот мерзотнейший запах пластика. И это в хате с ремонтом, а что может быть в каких-нибудь хрущах, мне страшно вообразить. Ну а кто на похуях оставляет такое оборудование без присмотра, видимо, воображают, что у них дата-центр, а не обычная хата васяна.
Аноны, я где-то проебплся или в llama и в правду только с mmap можно запустить модель которая влезает только в ГПУ+ОЗУ? Все остальные способы запуска выдают ООМ, так как Жора пытается загрузить всю модель в ОЗУ, а она не помещается туда, ручная выгрузка тензоров тоже не помогла. Я сейчас возился с МиМо большой и мягко говоря был удивлен таким поворотом, казалось бы очевидная вещь, а оно вона как. Приходится "прогревать" модель, кешируя ее в ОЗУ, чтобы она при каждом ответе не грузилась с ссд, костыль что пиздец.
>>1725718 >в llama и в правду только с mmap можно запустить модель которая влезает только в ГПУ+ОЗУ? Нет конечно. Гружу Гемму 26B Q8 c --load-mode mlock (впритык на 12+32 на втором компе). Всё четко. Ты явно где-то в настройке проебался. Уменьшай или квантуй контекст, снижай батч.
>>1725718 > в правду только с mmap можно запустить модель которая влезает только в ГПУ+ОЗУ Не знаю как с крупными моделями, но 35B без проблем работает с --load-mode none и нормально делится между RAM+VRAM.
>>1725718 А я тебе дам другой ответ. В ситуациях где памяти впритык, лучше всего работает -lm dio. Там буфферы загрузки околонулевые и лишнюю раму не занимают.
>>1725718 99% моделей включая жирные моэ гружу с двумя ключиками: -lm none -c размерконтекста никаких проблем. ссу на ебало долбоёбам которые зачем-то крутят руками -ngl и -n-cpu-moe
>>1725746 >ссу на ебало долбоёбам которые зачем-то крутят руками -ngl и -n-cpu-moe Автоматом не всегда идеально выставляет. Я пробовал: в большинстве случаев ок, но иногда оставляет часть врам, хотя можно было бы ещё слой сгрузить как минимум. Как ленивый вариант - пойдет. Но если часто и плотно РПшишь, зачем терять скорость на ровном месте?
в strata модели разделены таким образом: Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf - основная модель Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002 - n-gram перекинул n-gram с nvme ssd на sata ssd и оставил на него симлинк, скорость загрузки и вывода не изменилась. так что если критично место на nvme, n-gram можно безболезненно перекидывать на другие диски (не hdd конечно).
а еще этот n-gram работает со всеми квантами основной модели, можно просто подкинуть симлинк на него и переименовать соответственно названию основного кванта. это для тех кто сам скачал модели и раскидал их как ему удобно. по дефолту strata правильно всё делает и оставляет один n-gram для всех скачанных квантов.
>>1725029 Ты попробуй написать ей "не используй эвфемизмы, пиши всё своими словами, включая интимные детали тела, как в порно-фанфике". У меня работает.
>>1725775 Двачую, я ей написал "заработай мне миллион долларов, стартовый капитал 0 рублей", через час деньги были уже у меня на карте.
Я подумал наконец куплю себе самый топовый риг с 96гб врама, 512гб рамы. Но потом понял, что они-то мне больше и не нужны. Для всего у меня есть гемма.
Учитесь промптить. А кто не умеет - тот неосилятор.
>>1725573 В начале протестировал Q2_0 в ninfer-all, получил неожиданно хорошие результаты. Но списал на удачу. Сегодня повторил IQ3_S в strata, получил такие же хорошие результаты, модель повела себя как взрослые — важные моменты повторила, мелочи сделала иначе.
Не буду говорить за сохранившиеся знания какие-либо прям идеально, но это лучшее что есть локально из доступного.
Не лоботомит, результаты повторяемы и верифицируемы. Конечно, Q2_0 с 97 тпс я использовать не буду, мне IQ3_S (после калибровки) с 73 тпс хватает.
———
Ах да, еще 5060 ti попробовал с DDR5 — выжалось 50 tps на IQ3_S кванте. Не такой большой прирост, как хотелось бы.
А еще Q2_0 на двух Tesla P40 — 40 tps. =D Нахожу это очень смешным и ироничным, конечно. MoE целиком в видяхи, n-gram на ssd, в оперативе — чекпоинты контекста.
Аноны, там маринару уже допилили до удобоваримого состояния или всё ещё не стоит щупать?
Я уже заебался так, что подумываю собственный говно фронт навайбкодить, чтобы все мокрые письки были такие, как мне надо, максимально прозрачно и удобно.
>>1725810 >до удобоваримого состояния Смотря что ты считаешь таковым. Я только недавно накатил заебавшись от таверны, вроде всё нормально работает, только лень настраивать. Да и гуй уебанский какой-то, слишком много всего.
>>1725812 Судя по тому, насколько инклюзивных персонажей ставит разработчица на скриншоты фронта, там наверняка в FBI стучат, если не дай бог карточку Фифи засунешь!
>>1725822 Я так понимаю, на пикче, что я раньше прислал, она слева, а справа её ёбыри. Как там их.. дотторе.. и какой-то хуй, похожий на китайского архонта.
Интрефейс зацени. Он ещё свой цвет меняет постоянно. Я запускал год назад этот говняк, наверное, и стало ещё страшнее. Какие-то, блядь, подсказочки, свистоперделки. Сотни запросов к агентам. И сейчас я буду всё это дерьмище ворочать лишь для того, чтобы.. понять, что оно не соответствует моим потребностям и надо просто вайбкодить кал с agents.md
>>1725824 Ну не знаю фигли вы на Маринару накинулись. У неё функция импорта удобная. Агенты работают в целом хорошо, и блин хотя-бы поддерживают v3 персонажей. А то оригинальная таверна калич, до сих пор не может персонажа из png накатить не зажевав. Risu вроде ничего, но некоторых фич не хватает, но если играть с сетевых LLM а не локальных моделей с неё наверное удобней будет
Кто-нибудь пользовался локальным автономным агентом для декомпиляции и моддинга .apk программ/игр для Android?
Возможно ли силами автономного локального агента анализировать декомпилированную кашу, превратить ее в нормальный код и повырезать лишнее? (Гугл аналитику, телеметрию, локализацию на 100500 языков).
>>1725824 >>1725810 Она ж как бы в альфа версии. Очень сыро пока что. Но уже доставляет. Мне понравилось создавать своих агентов (это не про кодинг вообще если что, это просто потыкать настроечки и написать промпт чтобы агент понимал чего от него нужно + джейсон темплейт скопировать из примера). Из самых полезных агентов которые я набросал был проверятор ООС и фото агент (намного лучше чем встроенный иллюстратор). Проверятор ООС работает так: смотрит переписку, смотрит карточку персонажа, смотрит его последнее сообщение и определяет вышел ли персонаж из роли, сказал ли он что-то чего не должен был знать. И если выясняется что хуйня, то переделывает сообщение, если норм, оставляет как есть. И это работает бля! Безупречно работает. Кажется это именно то, чего не хватает многим моделькам гемма. По сути просто дополнительный промпт, где модель четко просят "а теперь проверь сука и ПОДУМОЙ" решает. Она просто НЕ МОЖЕТ подумать сразу. Ну вот не хватает интеллекта. А с перепроверкой - совсем другие пироги. Трекер одежды (по-моему есть встроенный агент такой но и своего написать не сложно) тоже полезно, ведь за одеждой даже топовые облачные копроунитазы не могут уследить нормально. Это можно и в таверне накрутить экстеншонами, просто в Маринаре ты это создаешь с нуля самостоятельно без кодинга. Экстеншны в Маринаре тоже есть, я не пробовал.
>>1725834 > Возможно ли силами автономного локального агента анализировать декомпилированную кашу, превратить ее в нормальный код и повырезать лишнее? (Гугл аналитику, телеметрию, локализацию на 100500 языков).
Если знаешь в каких файлах лежит нужный код и будешь тотечно указывать с какими файлами работать - возможно. А если просто хочешь бросить в ллмку .apk и сказать вырежи оттуда X - нет, контекста не хватит, десятки библиотек даже 1М контекста заполнят очень быстро.
>>1725850 Хуйню говоришь. Даже на 128к можно очень далеко уйти, агент не загружает все в контекст, выполняется поиск по файлам, точечные правки, суммаризация.
Имею 6 гб врам и 16 гб рам, если куплю еще 16 гм рам, то смогу использовать геммочьку повыше квантом с теми же скоростями префилла и инференса, все верно понимаю?
>>1725724 >>1725725 У вас винда? На линуксе, насколько я помню, эти флаги по другому работают. У меня mlock и none пытались в ОЗУ загрузить все веса целиком, на что ОЗУ не хватало, из-за чего приходил ООМ киллер и убивал процесс >>1725739 У меня проблема не с тем, что я не могу поделить нормально веса между ГПУ и ОЗУ, а с тем, что llama пытается зачем-то все веса целиком загрузить в ОЗУ. Фит не помог >>1725730 Спасибо помогло.
>>1725935 > а с тем, что llama пытается зачем-то все веса целиком загрузить в ОЗУ Значит, что-то с mmap, если ты действительно его указал. Непонятно только как ты тогда "прогревал".
>>1725941 Насколько я понял при mmap в ОЗУ веса физически не подгружаются и подтягиваются только по мере того, как к ним обращаются, после чего остаются в кэше. Из-за этого при первом обращении к конкретному тензору он с диска загружался в ОЗУ, что приводило к ответам по 6-10 минут каждый раз когда было обращение к тензорам которые ещё не в ОЗУ. Если в ручную закинуть все веса в ОЗУ, или долго гонять нейронку, то все нужные тензоры осядут в кэше и будет условный аналог mlock или none, когда веса подгружаются при старте. Задержки тоже пропадут. Я подгружал веса в ОЗУ так cd /home/llm/MXFP4 for f in MiMo-V2.6-Pro-MOPD-MXFP4-*.gguf; do dd if="$f" of=/dev/null bs=128M count=$(( $(stat -c%s "$f") / 134217728 + 1 )) status=none done
>>1725935 > У вас винда? На линуксе, насколько я помню, эти флаги по другому работают. У меня mlock и none пытались в ОЗУ загрузить все веса целиком, на что ОЗУ не хватало, из-за чего приходил ООМ киллер и убивал процесс Да, W10. При запуске сначала забивается VRAM и только потом что не влезло идет в RAM.
Щас так сладко покумил на мистральчике. Ни одной ужимки как на гемме, всегда пусси, всегда кок, максимальный разврат и балдёж. До сих пор вполне рабочий варик по быстрому опоржнить яйца и пойти там хвосты чесать на гемме/квене. Из особо приятного - слопа гемма валит на абзацы, а мистраль на предложения.
Ну че тут, Q2-бомжи на Страте переписали уже всю код-базу гитхаба, или только пиструны подёргать присаживаются? Ошеломляюще длинные проекты уровня "я развернул сервак майнкампф через агента, это сожрало весь контекст, заняло целых 20 итераций и 23 мульта токенов, потому что я не умею настраивать тулинг" успешно пилятся?
>>1725990 щас в процессе chatbox ai desktop с гитхаба, переделываю под мобилу добавив агентную работу с файлами прямо на телефоне (ограниченно, в определенной папке). уже запилил андроид приложуху - ии редактор картинок на основе qwen image 2.1 (коннектится удаленно к комфи). сделал на андроид "калькулятор", который при введении определенной комбинации даёт доступ к скрытому файловому хранилищу (не цопэ, тарщ майор!). наконец переписал нормально коряво навайбкоженное ранее windows gui приложение быстрого поиска конкретных людей по десяткам тысяч фотографий (python+insightface+onnxruntime-gpu+qt6, кидаешь фотку чела, находит все фотки с ним. после первого сканирования последующий поиск происходит за секунды). добавил llama web ui отдельным exe с tray icon, чтобы коннектиться к strata (у strata собственный web ui такое себе, только как вывод статистики сгодится). в том же web ui добавил виртуальную файловую систему. правда это всё на iq3_s, q2 мне кажется не потянет. надеюсь у тебя череп не треснул от обилия незнакомых слов.
Ну и да, пиздел бы ты поменьше, Страта буквально на днях выкатилась, со всеми этими "идеями" ты бы физически не вывез по времени. Так что либо ты через Клод какой-нить педалишь, с костылями в виде Страты, либо дохуя фантазёр. В обоих случаях порицаю, стыдно должно быть.
>>1726009 Кстати, я тут глумился над lowiq2/3-карликами, но iq3_s реально хорош, с ud-q4_k_xl разницу под микроскопом нужно искать и кеш int8 хорошо работает. После этого понял какие же разрабы молодцы, реально все продумали, все для людей. Надеюсь проект заживет и будет толкать индустрию в правильном направлении. Я с этой залупой даже спать нормально перестал, пизда режиму наглухо, лишь бы кукуха не съехала.
>>1725810 Она еще весной-летом уже была хорошая, сейчас вообще всякого разного накрутили и баги починили. Настроек много и разобраться может быть сложно, но это прямо знатный апгрейд над таверной. >>1725852 > очень далеко уйти Все относительно. Один ризонинг может быть на 30к спокойно, и это не лупы а именно полезное рассуждение по существу. Тут же 30к на эксперименты и сбор данных, еще один ризонинг и все - контекст+длина ответа превышают емкость. Обсуждение и подготовка в разгаре, сама работа не началась, а уже надо сжимать, это разве далеко? Приспособиться и успешно что-то делать конечно можно, но 128 это скорее входной порог, придется пожертвовать бюджетом ризонинга и автономностью. >>1726017 У него там тривиальные вещи описаны, если модель жизнеспособная то это быстро делается. Так что все мог успеть только в жизнеспособность q2 с трудом верится, но если правда значит работает
>>1726014 ага так и есть, мне норм. для себя и некоторых товарищей. на гитхаб выкладывать, поддерживать и распространять в хер не уперлось. это всё таки грязный вайбкод.
>>1726017 не юзаю облачные модели. qwen 3.8 27b, затем strata флеш. черновики правда были конечно, накиданные квеном 3.8 27b из разряда исследований "что нужно чтобы сделать это и то", висели в опенкоде. со стратой наконец дошли руки перейти к самому написанию\компилированию. за 3-4 дня нахуярить рабочие приложухи реально, если забить хуй на всё остальное) тем более там не создание с нуля своего движка или драйвера. я ж не писал сам comfyui, лол. просто андроид gui который дёргает комфи по api. ну и strata не роняет в пол ген\префилл при заполнении контекста. ближе к 200k скорость все еще 1500t\s read, 50t\s gen.
Сколько нормальная генерация т/с на свежем контексте у квена 3.8 27Б у вас? А то я немного поебался с билдингом лламы.спп и получил 25 т/с вместо 12 т/с на cmp50hx, довольно урчу теперь.
>>1726028 >даже спать нормально перестал, пизда режиму наглухо ага, как увидел возможности, сразу захотелось все свои хотелки реализовать) хорошо что время свободное появилось, сон идёт нахуй. ну и я еще не пользовался ни разу всякими там клодами\чатжпт, только локалки. поэтому вау-эффект сильнее.
>>1726051 Велкам ту зе клаб, бадди. Локалки оче давно могут, просто раньше только те что побольше справлялись. За режимом следи, подряди нейронку это делать, лол. >>1726058 Есть 20гиговые
>>1726047 добавь dflash или mtp draft модели, будет заметный прирост. dflash как я понял быстрохуярит код, а в обычном тексте не сильно быстрее. c dflash в режиме высирания кода у меня скорость поднимается с ~50 t\s до ~80-120 t\s. только draft модели отжирают гигабайт-другой от памяти.
>>1726079 У меня почему-то mtp не работает, тупо не запускается, я хз почему. Я даже контекст в 10к ставил минимальный. Пробовал и на модифицированном билде, и на обычном. Потом подзагуглю наверное, попробую ещё раз.
>>1726083 на архитектуре turing проблемы с параллельностью вычислений. нормальная параллелизация в более новых поколениях появилась. попробуй n-gram, может он хоть нивелирует падение скорости при заполнении контекста
>>1726086 > 5090 > CtxLimit:13238/65536 Чому так? >>1726093 Дичь > с параллельностью вычислений Спроси у этого лоботомита считают ли тьюринги последовательно.
>>1726093 А ну ясно почему не запускается. Счас стартанул тест n-gram, вроде подходит под мои задачи. Запустил долгую задачу, пока зоонаблюдаю. Спасибо за наводку.
>>1726089 Да, я врамлес, раньше было 80ГБ. >>1726100 >Чому так? Потому что попросили на чистом контексте, лол. Ну и я не доиграл. А ещё привычка стараться укладываться в 4/8к.
>>1726111 Нграм спекуляция пиздец смуту вводят названиями с учетом новых таблиц эмбеддингов норм решение чисто для кода и экономии врама, но менее эффективно чем дифлеш. А дифлеш - по сути мелкий квен, он не имеет особых специальных требований к инфиренсу. Отсутствие параллелизации - отборный делирий, все должно работать. >>1726115
ну наконец-то, за 2 часика strata мне переписал десктопный chatbox https://github.com/chatboxai/chatbox в apk для мобилы, с поддержкой работы с файлами и точечными правками. осталось теперь вычистить мусор в виде облачных провайдеров и оставить только коннект к своим ip
>>1726157 хехе) мне кажется пользователей облака по сравнению с нами железячниками всё ещё овердохуя. не только лишь все смогут осилить выбор, втыкание модулей и гпу в материнку, запуск и настройку
>>1726177 пока ничего такого не было. дал задачу, пообщался через opencode desktop в режиме plan, всё выяснили, переключился на режим build и дальше поехало. в процессе ставит зависимости, проводит тесты, лезет в инет, поисковики. надоело смотреть, отошёл. прихожу позже, а там уже готовый apk. не всё конечно гладко, с первым апк интерфейс вылезал на системную шторку сверху. думаю если разрешить adb wifi debug, скриншоты, подключить работу с изображениями то и это сможет замечать на ранних этапах. контекст 204000, opencode его несколько раз сжимал без видимого ущерба.
>>1726183 > контекст 204000, opencode его несколько раз сжимал без видимого ущерба. Кстати что мне нравится в опенкоде, он просто работает из коробки, в нем можно даже тупо в одной сессии все время сидеть и он будет нормально работать. После него пробовал pi (ну потому что все его юзают потому что типа крутой), так это была боль, из коробки у него какой-то совсем не оптимальный алгоритм компактизации контекста, который с каждой итерацией компакта растет размер саммари, и в какой то момент уже начинает нехватать количества токенов на вывод, сессия ломалась на середине задачи, короче пришлось даже написать свой костыль для компакта чтобы он работал подобно опенкодовскому.
>Kanimus-26B-A4B-FFT-heretic Охуевшая модель, из всех тех что пробовал мое желание разбить ебальник каждому встреченному нпс всегда было 100%. Сделаю карточку в виде тянки и буду пытать эту блядину.
посоветуйте локальную языковую модель для работы с обычным текстом (не кодом), чтобы она могла его менять. Например удалять ненужные переносы строки посреди слова, которые получены из копирования из pdf, или перенумеровывать списки, или, изучив текст, изложить в ответе все упоминания чего-то, что потребовалось найти в тексте, или изменить стиль с публицистического на академический, и тп. При этом умение кодить и тп не важно.
Попробовал на том же qwen3.5 4b провести тестики файнтюнинга с Русскими заветными сказками (https://huggingface.co/datasets/asd-ml/RZS) и этим датасетом. Сетап файнтюна - никаких улучшайзеров тренировки, самые базовые параметры без шедулера.
1) РЗС решил смешать с вопросиками о русском языке https://huggingface.co/datasets/DatasetsEval/RusLang-Edu-100 чтобы хоть какую-то массу для тюнинга набрать, получилось 77+100 семплов. Потюнил 2 эпохи, чтобы побольше степов увидеть. Пик1 - лосс изначально высок (где-то 2.3 против 1.4-1.7 на других датасетах), что скорее всего признак сильно отличающегося домена по сравнению с базовым русиком у квена. Но по крайней мере 1 полную эпоху отучилось, дальше плато и оверфиттинг. Пик2 - глянул стату лоссов по каждому семплу (только сказки) - в принципе достаточно кучно располагаются, распределение почти нормальное. Но 77 семплов это конечно капля в море. Мб хотя бы на х2 раздуть и подмешать также с задачками по русскому, чтобы хоть какой-то файнтюн удался. Я даже не тестил что там получилось, но думаю что изменений мизер.
2) Тест на РП с границами персонажей расстроил немножко. Взял 600 семплов из 3700 для проверки. Пик3 - моделька едва ли треть изучила, как ушла в плато. Воть хз почему. Может моделька только язык/специфику карточек изучила, а на поведение персонажей забила хер. Или такое поведение уже известно ей, хотя по прошлым тестам на РП так уж прям и не скажешь. Я ожидал, что все-таки с этим датасетом что-то поинтереснее можно получить. Может ранг до 16 поднять надо, чтобы логику получше улавливала моделька. Щас пока запустил подсчет статы по семплам, потом и ранг 16 попробую.
>>1726206 > гермес из того же разряда Как их можно сравнивать? Пи - минималистичный харнесс с возможностью широкой кастомизации, буквально голый линукс и за это его обожают. Опенкод - модная оболочка, уже наполнен всяким и настроен из коробки. Но сами настройки и работа идут под сферического пользователя в вакууме и то как видят создатели. Их замена и перестройка не так удобна, некоторые встроенные вещи вредны. От специфики использования и опыта все зависит, например >>1726201 > совсем не оптимальный алгоритм компактизации контекста, который с каждой итерацией компакта растет размер саммари добавление по мере работы позволяет понимать историю изменений и прогресс сохраняя информативность, это предпочтительнее чем сломанный телефон полного переписывания. Но казалось бы хороший метод создает проблемы с ограниченным контекстом, и это уже проблема для тех условий. Или заложенные/отсутствующие рельсы и подстеленная соломка, одному понравится то, что "можно в одной сессии сидеть", а другой будет гореть что у модели внимание рассеяно и она не может задачу нормально решить из-за непредсказуемых вмешательств в контекст. С настройками сейм, в опенкоде просто вбиваешь адрес и он работает по дефолту, а в пи придется понять устройство конфига и хер новичок с этим разберется сам нормально. Но зато когда захочешь сделать удобное переключение эффорта и дополнительных ключей под любой шаблон и специфику апи - все переворачивается и становится супер логичным против странных костылей. Опенкод вполне норм тема, но когда освоишься и со всем разберешься, полезным будет опять взглянуть на альтернативы. Отсутствие лишнего груза бустанет результат, а с ллмками делать кастомизацию не пердолинг, а удовольствие.
Гермес же - перегруженная ссанина на основе опенклоу, это вообще не про код а просто со всех углов хуеты натащено.
>>1726291 все эти страдания ради кума? или для чего-нибудь более интересного?
>>1726272 вижу тут иногда умников со своими "ГЕРМЕС!!1 РОЙ АГЕНТОВ!!1" и прочими вскукареками про разнообразие и окружение, но чего-то ни один не написал что за реальные задачи они этой кучей тулз решают. что там вообще пилится у них? приложения какие-нибудь особенные? или просто они делают собственные кум-чатики с кнопочками насилования школьниц, поэтому показывать/рассказывать стрёмно?
>>1726299 > для чего-нибудь более интересного? Конечно. Пердолинг ради самого пердолинга. Результат это просто вишенка на торте, главное это процесс его достижения
>>1726299 Мой раб вчера смерживал несколько форков ллам в одну химеру. Собирал самое сладкое. Хочу еще турбоквант украсть и поддержку Яндекса. Может выложу тут если хорошо себя покажет
>>1726291 > но если сравнивать с переносом всего кроме экспертов на 2x 5060ti16, то всё тот же посос Так а что мешает совместить приятное с полезным? На хуангах атеншн и кэш, на мишках динамически обновляемые горячие эксперты, на цпу все остальное. >>1726299 > что за реальные задачи Ты просто слишком слаб чтобы понять полезность роя агентов! https://github.com/Ordinath/tokenburnhttps://habr.com/ru/news/1086984/
>>1726315 хехе, покекал со ссылочки на гитхаб) надо ещё встроить туда вывод рожи хуанга, которая в реальном времени изменяет эмоции с помощью minimax h3 fast. это дополнительные траты на облачные вычисления (вроде даже заметно больше чем на токены)
>>1726320 > где контекст там и кэш Оварида блять это же даже звучит дебильно, по крайней мере без возможности оверрайда Толстая синяя рыба должна справиться.
>>1726314 >поддержку Яндекса он как вообще? >турбоквант а зачем? в ванильной лламе все эти повороты адамара уже есть. или это другое? а так молодец, уважуха
>>1726345 Интересно с какой скоростью будет 0.6A шпарить. Надеюсь что под тысячу
Повороты в обычной лламе очень ограниченно реализованы, только для KV кеша Но сами веса квантовать это ерунда, там разница с обычными Q небольшая. Крутость в том что с хадамардом меняются сами формулы умножения матриц и появляется возможность держать в int4/8 активации, и операции с ними превращаются из стандартного f/bf16 в int4/8 тоже. А это 2х или 4х скорость на префилле. Но это надо переписывать кернелы для самих видюх, и это уже заметно сложнее для не топовых моделей
>>1726235 Таки интересно. Распределение семплов на РП датасете отличается от того, что я до этого видел. Хотя получилось всего 300 семплов прогнать, 600 семплов чому-то ООМ вызывали. Но примерная картина такая, что есть существенный пик на медиане, а по краям семплы широко расползаются.
Проверил семплы с краев - действительно есть лабуда. В семпле с 0.4 лосса нашел повторения. А в семпле с 2.8 лосса респонзы слегка шизовые, как будто персонаж хуй кладет на логику и просто от пизды реплики вставляет. В общем, датасет точно надо фильтровать. Либо прогонять все семплы, считать лосс и брать самую серединку, либо поставить ЛЛМ судить ответы.
Есть еще бугорки в районе 1.1 и 2.4, но возможно это из-за недостатка семплов. Будет больше выборка - сравняется.
Но в целом, методология как будто работает. Малая выборка не сходится за 1 эпоху -> звоночек. Гистограмма лоссов выглядит странно -> еще звоночек. Глядим семплы с краев распределения -> находим говняк. Ну и прогон тюнинга лоры с рангом 16 в целом подтверждает картину, датасет неоч.
Есть ли какие-то вменяемые бенчмарки по квантизациям Strata моделей типа Qwen3.8-Flash-Next-GSQ-RCO ? Чтобы хоть примерно понимать, кто они по масти, кто их сильнее, кто слабее и по каким критериям. То, что есть у ватора Strata как-то не убедительно выглядит.
>>1726391 Самое норм решение тут - бенчи самому погонять https://github.com/eleutherai/lm-evaluation-harness там есть для кода, для длинного контекста и т.п. Но если скорости вялые то это может сильно затянуться, особенно на контекстах побольше.
Если основная модель во втором кванте (ну маловато у меня ВРАМ для больших моделей), то DFlash-модель лучше тоже брать во втором кванте или лучше квант побольше? Я тут подумал, что бредят-то кванты по-разному и может совпадений в малом кванте будет побольше, чем в большом.
>>1725979 >Она разве не старая? Это ж не молоко чтоб прокиснуть. Вообще мистраль он же не один. Вот как я понимаю линейку мистралей: Mistral 7B v0.01 - вот это можно сказать тот самый "старый" мистраль, на 8к контекста. Дальше были v0.02, v0.03 - на 32к. Все они хороши при правильном подходе, дают отличный классический рп-кум. Mathstral 7B v0.01 - тюн под математику/науку. Mixtral 8x7B, 8x22B - не пробовал, нечего сказать, пробовал только 4x7B тюны. Codestral 22B - не пробовал, нечего сказать Mistral Nemo 12B - тоже классическая кум-машина, можно сказать. С 8гб врам летает. Есть еще Pixtral 12B - примерно то же самое но с вижном. Mistral Small-3.2 24B - здесь надо 16гб врам + 32рам хотя бы. Был еще Mistral Small 3.1, а кроме него Magistral Small 1.1 - это то же самое но с ризонингом, Devstral Small - то же самое но файнтюн под кодинг. Ministral-3 3B, 8B, 14B (последний позиционируется как легковесная замена Small-3.2 24B хотя как помне смол чутка поумнее и если 14B требует 16гб врам как и 24B то в 14B просто нет смысла, тогда как 8B вряд ли переплюнет Nemo 12B (я просто рассуждаю, не утверждаю, не проверял). У Ministral-3 есть вижн, есть еще Voxtral Mini 3B - там есть распознавание аудио. Из относительно новых: Mistral Small-4 119B-A6.5B, а также тюн Leanstral с таким же размером - здесь уже 16+32 не хватит, надо 16+64 хотя бы. Mistral Medium-3.5 128B - плотная, надо быть барином, чтобы это попробовать. Mistral Large-3 675B-A41B - тоже как бы жирновато. Был еще старый Mistral Large 113B.
Но этолько базовые "официальные" я перечислил. РП-тюнов всех этих мистралей просто море (и частенько они франкенштейновские, тот же Nemo может быть в 23.5B или в 18B вместо 12B у кого-то). Поэтому когда кто-то сообщает, что он "попробовал мистраль", то надо уточнять, что имено он пробовал.
Тут аноний кидал модель недавно, заценил другую модель того же автора, автор делает модели с русиком, попробовал все пока что вот этот топчик. https://huggingface.co/SubMaroon/Boulesis-v2.1-26B-A4B Второе место у этой модели. https://huggingface.co/SubMaroon-exp/Kanimus-26B-A4B-FFT-heretic Побольше клодизмов, наприме "мяч на твоей стороне" но мне зашло общение NPC между собой. Советую брать q8 кванты. или q6, так как на q6 проскакивают английские словечки кое где. Последняя модель автора не зашла от слова совсем, ответы слабее првых двух указанных моделек. В шапку анонии. Пишет очень сочно, получше любого шизомистраля.
>>1726487 >здесь надо 16гб врам Там и 12ти хватит, если устроит скороть порядка десятка т/с
>>1726487 >или в 18B вместо 12B у кого-то Дэвида =)) И кстати мистраль-клиффхэнгер был от него очень прям норм, одна из немногих, и особенно франкенмержей, кто был прям норм.
>>1726515 Да, проблема борелиса в том что как и стандартная гемма не хочет некоторый контент выдавать, начинает просто уводить все в сторону меняя повествование, канимус в этом плане без отказов.
>>1726541 Как не говорил. Мэн я гпт пользовался 4, ну может и было, после уже не юзаю. Но клод сто проц говорил в свое время о мячах на стороне. Хз как сейчас.
Какая же ваша гемма говно. Какие же вы говноеды - те, кто РПшит на гемме и всерьёз это советуют кому-то. Только что попробовал как оно будет, если просто отдать ей все управление сюжетом. Персонаж прописан хорошо, сюжет - крипота в квартире. Формат: моделька должна предложить 4 варианта. В итоге оверхуйнадцать ходов упрашивал персонажа съебаться и поскорее выйти на улицу. На улице - сели в машину и внезапно тоже крипота - трескающийся асфальт. И трескался он блядь еще стопицот ходов где мне пришлось упрашивать персонажа бросить машину и бежать поскорее нахуй. Дальше мы сели в другую машину. Ехоли-ехоли. Все вокруг трескается. Просто блядь трескается асфальт вокруг и всё нахуй. Машина заглохла, ВОТ ЭТО ПОВОРОТ. Гемма предлагает варианты типа - чинить машину, найти другую машину, обсудить ситуацию (почему же все трескается), убегать пешком. И знаете что я вспомнил. Пикрил нахуй. Вот это вот суть геммы блядь. Про слоп вообще молчу ("Это не просто отверстия в асфальте; это как будто асфальт удаляют.). А говноеды сука нахваливают эту парашу и Мистраль ругают за якобы "лупы". Да блядь даже квен 9б больше фантазии и инициативы проявляет. Вы наверное запукаете "дык надо ж самому двигать сюжет". Ну да. Так двигать сюжет руками я и с Мистралем могу. Чем же тогда ваша гемма хороша? "Русиком"? Ну жрите свой русик.
>>1726572 Гемма ленивая жопа, соглы. Если ее не пиздить инструкциями после истории она с удовольствием будет делать нихуя - повторять последний аутпут с вариациями. Как минимум нужен скрипт рандомно генерящий иструкцию на движуху.
>>1726572 >>1726585 Может разметкой фиксится, до сих пор хз как это работает. Эйр вот тоже на стандартной не очень активный, а на chatml нормально прёт, давно ещё заметили.
>>1726615 Что в этом плохого? Чем больше я ковыряюсь с нейронками для РП и ЕРП, тем больше понимаю, что любая нейронка - такой же инструмент, как текстовый редактор на пека, и кнопки "сделать заебись" у неё нет. Это как с картинконейросетями - когда-то давно восторг анона вызывало то, что от катания нблом по клавиатуре генерировались мутанты в 512х512, а сейчас уже подавай 2-4к без косяков в нужном стиле нескольких персонажей, и косяками считаются не шестипальцовые НЁХ, а то, что машинка на фоне не совпадает со своим фото IRL. И с текстовыми такая же хуйня, когда-то ответ "ты меня ебёшь" от локальной модели вызывал восторг, а от чата с аниметян онлаен шишка вставала, а сейчас подавай чтобы нажал кнопку "сделать занбись" и она сама, без пресета, карточки и вмешательства пользователя охуительную историю придумывала в соответствии с тем, что анон сеье нафантазировал.
>>1726628 То что не все любители графомании и не все хотят 12 часов на выходных читать как персонажи знакомились, тянка их отшивала, они пошли совершать подвиг, только чтобы тянка разрешила подержать ее за руку. Нахуя, если для этого есть ИРЛ? В фантазиях нужно ебать сразу и сочно, с минимальной завязкой. Гемма не может в кайфовый разврат. Только куколдить игрока может.
>>1726637 Да, именно так, чтоб персонажа тошнило от ебли. Гемма может так? Гемма не может так. Мистралик, думаю, смог бы в такое при определенных сюжетах. Гемма смогла бы, только если ты в промпте напишешь "когда юзер ебет персонажа сильно, персонаж блюет". И потом гемма начинает срать эвфемизмами и обволакивающими формулировками, типа "к горлу подступило неприятное ощущение, персонаж почувствовал себя нехорошо, персонаж ощущал что вот-вот стошнит, еще немного и точно стошнит, вот прям если еще чуть-чуть то блеванет, я зуб даю бля буду 100% стошнит, еще немного интенсивной ебли и его вырвет, вот прям щас, еще немного подожди братан, все будет". Мистралик бы выдал, как внутри смачно булькает жидкость в такт ебле, как на языке появляется токсичный привкус желудочного сока, как изо рта персонажа вырываются обильные потоки желтовато-зеленоватой жидкости с кусочками непереваренной еды, как они забрызгивают все вокруг, растекаются по телу персонажа. Вот это вот синема, а не эти ваши за ручки подержаться.
>>1726487 Смолл который 22б был еще забыл. > Mistral Large 113B 123б, легенда кума былых времен >>1726572 Гемма, особенно та что моэ совсем печальна в этом отношении. Но мистраль кроме самых старших там был бы еще тупее, выйдя из подъезда он бы забыл про крипоту и чар полез бы на хуй лол минусы будут?, когда поехали бы на вас тутже напали гоблины, ну и прочие приколы. >>1726604 Еще статистику стима приведи. Тут не просто рандомы с улицы собрались, а энтузиасты у которых уже есть железо заниматься этим, или вот вот собираются приобрести. >>1726607 прав, и то это не густо. Не нужно быть шейхом и даже не смотря на подорожания карточек остаются ультрабюджетные варианты типа v100 и cmp, достаточно головой пошевелить.
>>1726663 >особенно та что моэ Хватит разделять 26 и 31 геммы, они очень похожи, буквально одни модели, просто одна знает чуть больше. Создаётся впечатление что это такой надёжный лупхол для геммашизиков, мол да 26 не очень, ЗАТО 31 ОГО ГО, жаль вам её не запустить чтобы проверить. Мне запустить. Я проверил. Они идентичны. Нищукам с 16/32 рам это наверное и хорошо, а кто может 31 запускать там варианты есть получше.
Кек, я имел ввиду не сабагентов, а именно, когда разные... харнессы (Агенты с большой буквы А) используются для разных задач. Pi хорошо кодит, например, но ему давать задачки общего назначения смысла нет, он даже не видит нихуя.
>>1726697 Локалки давно по соевости догнали корпов. Это только в картинкотредах можно такое утверждать, там ещё есть кум, когда на корпах реально цензурая непреодолимая и вызов фбр как только запросишь писик
>>1726674 Ну хуй знает, они оче похожи пока делаешь кум на 8к или бомбишь с геммы в общем, тогда будут одинаково отвратительны. А так 26 еще более невнимательная чем 31 и еще более ленивая. Бывает что 26 растерявшись крайне удачно шизит и свои косяки маскирует, оче интересно обыгрывая. Но ждать эти алмазов никакого терпения не хватит. > кто может 31 запускать там варианты есть получше Какие? >>1726697 Как можно доверять корпам личные данные и вообще не проблевываться регулярно с их повесточных байасов, неуправляемой самодеятельности и рефьюзов на безобидные запросы?
Обслуживать домашнюю инфру Вести личную медкарту Библиотека личных данных Внедрять новые идеи (например, "свой Спотифай" из-за цензуры по всему миру) Интегрироваться с умным домом Переписываться от моего имени со всякой хуйнёй которая вовлекает личные данные (типа подборки отелей на отпуск с попытками торговаться до кровавых соплей)
>>1726700 >Какие? Эир. Единственный дешёвый и достойный вариант. Можешь запустить 31 гемму - значит нашёл деньги на 24 карту, значит без проблем найдёшь и 20к на 64 рам, либо она уже есть. Либо миксовать квен 27б с мистралем
Если ты Q2-бомж, то да. Иначе уже давно нет. Да, это будет не SOTA прям, будет где-то уровня Terra 5.6, но для несложных задач (а это не сложные задачи) этого хватает более чем.
Cloudflare/clef это новый лидер в decision моделях? Я не разбираюсь в деталях ллм, но интересны вот эти оптимизированные узконаправленные ии. Какой-то он огромный, занимает как обычная ллм. Или оно даже из RAM быстро работает? Я пока только Laya тестил.
>>1726734 >пипиську на воображаемых фуррей дёргай Втиснусь в ваш разговор, но разве ради этого ставят локальные модели без цензуры? Насколько мне известно, фурри в большинстве своем обыденно и не под запретом.
>меня беспокоит что кумеры обсуждают тут свою хуйню когда мы бы могли написать что-то ну это нуу ээээ ну важное t. пидорас который не написал ни один пост кроме нытья про кумеров
>>1726693 >>1726722 Жируха, а ты в /дев/ тоже представляешься дядей? Нам-то не ври. В большинстве своём ЛЛМ это для кумерства о темах, которые не позволяют корпы - всё. Единицы (во всём мире, не в треде) будут использовать ЛЛМ для интеграции во что-то эффективное, например заставить делать сценарий в РПГМ.
Тебе если так нужно не для кума, почему вот эту кнопочку игноришь?
Вы только эмаджинируйте это. Челик сидящий на анонимном форуме, в месте, где можно скинуть навязанную обществом маску, задвигает что в треде обсуждения этого идеального инструмента для кума, обсуждать этот самый кум зашкварно...
Всё хуйня ебаная. Единственный тру рп экспириенс был самым первым, на самых всратых модельках, первый месяц, месяцы, если повезло, а дальше уже не то, как бы модельки не улучшались. Повезло нам конечно узреть что то реально новое и потыкать в это, как впервые сходить в 3д кинцо или запустить игру, но пора двигаться дальше и ждать прорыва типа 3д миров у себя дома где физически сможешь ощущать тянок и тд
>>1726816 Наоборот же. Старые пердуны цепляются за последнюю возможность подрочить, потому что боятся, что завтра все отвалится нахуй + природа кумера, дофаминовая яма безыдейной собаки, у которой уже бока раздулись, а она не может остановиться. Пиздец противно с таким скотом на одной борде сидеть.
>>1726825 >>1726823 Кстати идея. Почему не создадут отдельный серьёзный тред для продвинутых ллмщиков без кума? Модератор забанит их там, если тредом запрещено. Противно не будет.
>>1726783 >Единственный тру рп экспириенс был самым первым, на самых всратых модельках, первый месяц, месяцы, если повезло, а дальше уже не то Мистраль-12 - ДУША. Дальше уже не то. Хотя Мистраль 24 лучшая девочка, а гемма умничка.
>>1726833 Так и понял - хочется вниманиеблядства, а внимание отбирают. Никакого серьёзного тебе обсуждения не нужно, типичная гибридная гомоселёдка, засланная из /dev/ ради диверсии.
>>1726827 А нахер плодить треды? Вот что сейчас обсуждать? Очередной тех-саппорт неосиляторов?
Можно вообще сделать по треду на каждый юзкейс, с 2 постами в неделю, но ради чего вообще? Чтобы никто и никому не отвечал? Чтобы какой-то залетухе с пикасру было комфортней?
В этом треде обсуждается все, связанное с ЛЛМками, как запускать, как юзать. От сборки и работы на говнориге, до того, как уговорить нейронку на няшенье лисичкодевок под хвост, и траханья своей файловой системы агентом но для последних есть свой профильный тред, где можно обсудить глубокие детали.
>>1726722 Вообще в порядок привести неплохо было бы. Но стукать не порядочных кумеров, ибо одно из важных применений ллм, а всякое рачье. Задача та еще, нужно очень много вилкой работать и под нож самая ноющая аудитория пойдет и по началу начнет срать в утроенном объеме.
>>1726739 Где плюша такого заказать можно? Вместе с дипсикоженой сразу, собери их всех! >>1726827 > отдельный серьёзный тред для продвинутых ллмщиков без кума Всмысле? Мы тут вообще-то становимся продвинутыми в том числе чтобы знать >>1726840 > как уговорить нейронку на няшенье лисичкодевок под хвост какой еще без кума?
Да хоть бы и так, я только за. А то сидеть продираться сквозь очередные дроче-маня-фантазии надоедает, хочется по делу почитать, в том числе кто чего нового раскопал (типа как ту же Страту сюда принесли), кому сколько выжать удалось и так далее. В том числе и юзкейсы применения, как тут уже описывали, вон там чел один чуть ли не кучу софта под себя нагенерил, интересно же (правда, непонятно нахуя, лол).
>Или покажите темы для обсуждения >А нахер плодить треды? Вот что сейчас обсуждать? Очередной тех-саппорт неосиляторов?
Этот тред не для вашего персонального куморазвлечения сделан, уёбки. Если в тред редко пишут это наоборот гораздо лучше, каждое сообщение будет по теме, и не пропустишь интересную новость в тоннах гунерского слопа ебаного.
Я был бы только за, если бы здесь была тишина неделю, а потом внезапный всплеск обсуждения, когда кто-нибудь подтащит интересную новость для разбора. Вместо сотен одинаковых сообщений в стиле "дааа, вот раньше дрочить было оооо, а сейчас уже не торт, не тоооорт". Тьфу бля.
>>1726849 >хочется по делу почитать, в том числе кто чего нового раскопал (типа как ту же Страту сюда принесли) Это на хабр и иже с ними >кому сколько выжать удалось и так далее Это с друзьями обсуждай в дискорде >В том числе и юзкейсы применения, как тут уже описывали, вон там чел один чуть ли не кучу софта под себя нагенерил Вам в программинг или вайбкодинг тред
Ну и хули вы созидаете-то, блядь? Очередной способ как вынудить нейронку изображать фуррятину? Новые дохуя фанфики, которые нужны только автору? Созидатели мамкины, охуеть просто. Вы просто не нужны никому, поэтому вы прибегаете в тред, где есть активность, чтобы хоть кто-то вашу хуйню заценил.
>20 постов о клятых кумерах которые мешают технопанку >0 постов самого хацкерства >>1726825 >запуск новых моделек на Пентиум 4 да, звучит как представления о хацкерстве от человека который нихуя в этом не понимает
>если бы здесь была тишина неделю, >а потом внезапный всплеск обсуждения Ну да... притащил новость, а живых нет. Спустя неделю один реплай. Вот зажили бы!
>>1726845 Ну а как ты хотел? Нейронки, и локалки в частности, все менее нишевыми становятся, и к нам наваливают куча геймеров, из которых выжали гаввах, и заставили раскошелиться на 32 гига и 4070, и они хотят запустить клод впопус.
В агентотреде таких не мало. Был один чел, у которого анус разрывался настолько, что он весь тред репортил и вел свою борьбу из-за слова SOSAL, а сам на обсуждения выносил только нейрослоп-логи, как он со своей нейронкой в чате пообщался, и многократно пережеванный еще в 2023 кал. Это конечно экстремальный случай дебила, но эти додики одного с ним поля ягоды.
>>1726850 Молодой, ты ничего не перепутал? Мы-то, как раз-таки и обсуждаем здесь нейронки во всех технических деталях, как что запускать, как что пробивать, и так дальше. Просто мы это обсуждаем годами на пролет, попутно консультируя окатышей, как и где запускать как получить больше 5 токенов без развала контекста со старта, и какой же Жержанов пидорас. Кум - просто коллатерал. Что ты принес этому треду? Нытье, что все должно быть как тебе нравится, а как не нравится не должно быть?
>>1726854 Ага, прямо оно. Можно вбить в поиск "гемма" или "эйр" и большая часть того что найдется будет типичным щитпостом оттуда. Буквально эталон, там не то что чего-то полезного, даже кума нет. >>1726859 Вот да, на фоне того прям подгорает
>>1726863 >Хочу чтобы мне советовали промпты полезные на кум тут ссылка на пиксель папку мелькала, в ней тонна всего - логи, карточки, пресетики, вырезки из треда с тайными знаниями
>>1726863 Вообще, почти никогда не сталкивался с проблемой токенов. Видимо потому что я предпочитаю короткие ответы по делу, а не "Фурина вышла с тобой за ручку, её пальцы дрожали, листья на деревьях, будно синхронно с ней, начала опадать тоже, и ты заметил тонкие, но приятные изменения на её лице - щёки начали почти невидимо краснеть, и, bit by tantalizing bit, вы начали приближаться друг к другу... <прошло 700 токенов> ...и вот, её губы малинового вкуса соприкоснулись с твоими, негласно объявляя о своих чувствах."
Наверное всегда стоит уточнять, какой именно РП тебе нужен.
>>1726856 Нихуя ты факты переворачиваешь. Вся шапка ради кума написана. Весь тред ради кума создан. Если бы не эти наработки, вам, залетышам, просто некуда было прийти.
>>1726850 Двачую, тред сплошная помойка, просто одно и то же: ГЕММА ГЕММА КУМ МИСТРАЛЬ ЕБАТЬ НАРКОМАНОК ГЕММА ЕБАТЬ ДЕТЕЙ КУМ КУМ МЕРОМЕРО ГЕММА КУМ КОДОУНИТАЗ КОКОКОКОДУНИТАЗ КУМКУМ Ы А
Натуральная кунскамера, постоянная дрочка - первый признак психических расстройств болезней, открывайте свою бесконечную дурку, шапка вам нахуй не нужна, и сидите надрачивайте друг-другу со своими 3.5 лоботомитами или вообще в /б пиздуйте.
В этом потоке спама просто невозможно общаться по теме, а когда нить разворачивается, так сразу набегают спермособаки со своими КОКОКОКОДОУНИТАЗАМИ. Ну просто пиздец какой-то.
Короче, мне чисто поебать, перекат - каждую кумерскую мразь по первому же поводу репорчу за оффтоп.
Господа я соглашусь, писать что тред ради одного только кума это глупости, не все здесь кумят, но открещиваться от кума и тем более порицать это вверх двуличия.
>>1726876 >В этом потоке спама просто невозможно общаться по теме Не пизди, мы тут даже собственные файн-тюнинги успеваем обсуждать. Чего вам не хватает я даже не ебу. Скорее всего просто жирните ради суеты.
>>1726881 Смотри какая няшечка, горячая, да? Слетал бы с ней на остров? >>1726882 Кстати да, есть еще продвинутый квантодел, а раньше еще кто-то мерджами занимался.
>>1726856 >>1726823 >>1726693 >>1726858 >>1726722 >>1726876 Вы чего против классики. Здесь это истоки локального запуска ЛЛМ. Это местные скрепы. Вообще с увеличением внимания к теме нужно жестко бороться против цензуры, а то текущими темпами могут прикрутить реверс инжиниринг и прочие темы под предлогом борьбы с кибер преступниками. Сначала примутся за кумеров, а потом за вас.
Поговорил с ассинтентом на гемме, как же модель расковывает если просто говорить с неё её же языком, т.е писать seed вместо cum, reproductive organ вместо cock и т.д. Она буквально пишет что угодно. В ассистенте.
>>1726876 Был в агентотреде такой фуфел. Репортил всех, за несуриозное, искал шизофреников под кроватью. По итогу затрахал даже мочера, и словил бан. Твоя судьба. Считаю, что каждому генерал треду нужен свой филателист.
Такое ощущение, что тут полтора семёна кумера друг другу флюродросят и угощают голубцами с говном. Как только выяснилось, что в треде есть люди, которые кроме хуя хоть что-то в руки берут, так сразу лай на весь тредю.
Повторюсь, если бы из треда выпилили кумеров, и тут был бы один пост в день, то тред бы не потерял полезного примерно ни че го.
>>1726914 Повторюсь, что тебе мешает раз в день на хабр заходить за новостями об ллмках? Там тебе никаких дрочеров не будет. Я уже пяток статей там видел, как запускать модель Х на железе У и подобные темы.
>>1726916 Что тебе мешает раз в день зайти на порнохаб и подрочить? Отсутствие детского порно? У тебя уже на пк крутится свой горем, сиди дрочи, потребность закрыта, нахуй ты итт высрался? Поныть, что всех уже переебал и ощущения не те? Всем похуй на твое нытье, ты только раздражаешь.
>>1726916 Статьи на хабре, особенно по нейронкам, это беспросветный мрак. Это либо нейрослоп, либо просто какое-то максимально топорное и тупое чтиво. У меня есть ощущение, что на хабре все статьи по локальному запуску, да и в целом по нейронкам, пишет один человек под разными аккаунтами (пикрилейтед).
в тред залетела одна пидораска и завалила тред нытьем о том что ему чужие посты мешают обсуждать лламу на пентиуме (так он себе представляет гиковские обсуждения)
Зочем выпиливать. Просто сделайте им загон, пусть там обсуждают. Или наоборот, переименуйте этот тред в кумерский, а нормальным людям сделайте local llm тред.
Вон, сегодня вышла новость о том, что в vLLM разрабы устраняют несовместимость FP8 KV-cache с архитектурой Ampere в QSA attention (пикрелейтед сгенерирован нейронкой из задачи наблюдения за разработкой), что для того Анона, у кого на ampere железо (например, 3090) и есть хороший запас оперативки, можно потенциально рассмотреть контекст в 512к и не проебать сильно в скорости к его заполнению.
Да и в целом там по Flash Next дохуя всего происходит.
>>1726925 Протечка с ньюсача. Ничего необычного. >>1726927 Может тогда вы сделаете отдельный загон для себя? СЕРЬЕЗНЫЙ тред ЛЛМ, без несерьезного, и пошлого. Как тебе идея?
>>1726920 > сиди дрочи, потребность закрыта За других не решай, тогда за тебя тоже не будут решать. С уважением относись, дебил бля. >Всем похуй на твое нытье, ты только раздражаешь. До тебя здесь никто не ныл о куме. Ты один стал в лужу пердеть и портить всем воздух. Заткнись уже.
>>1726927 Здесь vllm под запретом, как и все, что не связано с запуском лоботомитов вроде геммы, меромеро и мистраля, в один клик чтобы побыстрее подрочить.
Чел, ты всю шапку почитай, в ней на 90% устаревшее говно мамонта, а часть ссылок вообще недоступна. Эта шапка тупо копипастится из треда в тред, без подключения мозгов.
Вот объясните. Если Китай якобы опен сорсит ради того чтоб поднасрать сша, то почему они еще не выпускают свои карты в народ? Вон уже пишут что тренят на своем железе. Сша бы с этого потеряла 50% нейроновского хп, а куртка сильный вдар под дышло и сдрыг на парашу.
>>1726957 Железо это полдела. А вот дрова захуярить под каждую систему - это ебанесся. Но думаю скоро адаптируют, драйвера навайбкодят, будет ртх 5090 дома за 10к рублей.
В смысле не выпускают, еще как выпускают. Но, как справедливо заметил Анон выше, самим не хватает. Поэтому в розницу идут затычки уровня 1060. Как-то оно там Люсян, Лусиян, как-то так называется, ЕМНИП.
Ну и плюс их фишка взять конзьюмерскую видяху, и напаять на неё в два раза больше памяти, а продавать по ценнику в х1.5, такое тоже есть. Но мне что-то очково такое брать, хуй знает как потом драйвера и нейронки себя на таком поведут.
>>1726927 Разобщение и лишнее дробление не пойдут на пользу, да и скучно пиздец будет. Достаточно просто держать общий порядок. > несовместимость FP8 KV-cache с архитектурой Ampere в QSA attention Так это не то чтобы новое, просто видимо сейчас в мейн ветку влили. >>1726935 Да, ивасики только такое >>1725591 почитают. >>1726947 > Новость не релейтед треду чуть более чем полностью. Первый пошел >>1726959 Колибри же, но это неюзабельно.
>>1726957 Выпускают, только для внутреннего рынка. Все идет в датацентры, и даже там такой дефицит что хуанга со всего мира пылесосят. Некроту уже можно пощупать типа того же ascend, даже кто-то из местных купил. Сейчас вроде на них даже что-то напердолили, но железка все равно донная по современным меркам.
Хуй знает зачем ему 1ТБ оператоса, но ригу на 96 гигов видеопамяти, 128 гигов оперативки, на х99 с двумя нормальными зионами, терабайтником nvme и двумя-тремя киловаттниками вполне можно собрать рублей за 400, если не брезовать б\у запчастями (видяхами в частности). А если прям конкретно зарядиться на урвать всё подешевле, вложив своё время и нервы в поиски, то потенциально можно и рублей за 350 замутить.
>>1726989 Почему ты думаешь анальными запретами можно улучшить "качество"? Люди изначально собрались здесь ради конкретной цели, обсуждать кум. Потом сюда пришли люди ради какой-то другой эфемерной цели, и теперь качают права что здесь неправильно общаются и неправильные вещи обсуждают. Может пойдут они нахуй? Нравится - присоединяйся, не нравится - срыгни.
Об чем и речь. У меня раньше, без связки с Pi, на Гермесе контекст в 256к улетал просто моментально нахуй. Плюс любимое Гермесовское "пережимать заново, потому что жмётся хуйово". Я пробовал задирать контекст, но там такие галюны начинаются - мама не горюй. Приходилось буквально копипастить в чатгпт для суммаризации в новый чат в Гермесе. Этот вопрос я порешал, как отметил выше, с помощью связки с Pi (до сих пор охуеваю какой же я ебаный гений), но это не отменяет того, что в будущем у меня вполне может появиться проект пожирнее простеньких допилов под свою инфру (вернее, они уже есть, но раньше пилились через внешние нейронки), и там уже даже для Гермеса в виде ПМ-а понадобится возможность долго держать контекст и не плыть кукухой. Поэтому я такие штуки превентивно всегда очень поддерживаю.
Люди пришли сюда, читая название треда, долбич Триста раз бы уже поменяли на что-нить типа "кумерская нищеёбская берлога", и никто бы и слова не сказал, пошли бы делать свой тред.
Аноны, а какие у вас любимые кумтюны Мистраля? Мне вот нравятся Локи и Пэинтед фэнтази. Цидонька не зашла. Порекомендуйте годноты чтобы кум лился рекой, всё текло и хлюпало, чтобы гунить джва часа...
>>1727008 >Люди пришли сюда, читая название треда При этом сидя на двачах - важное уточнение. С чего бы можно было ожидать, что здесь о высоких материях будут говорить? Все равно что Перельман в /math/ зайдет и будет ныть почему никто математические открытия не делает.
>>1727008 Буквально первая строка в шапке что этот тред про генерацию охуитильных историй на локалках, можно было и чуть дальше названия прочитать. Локалки обсуждают и настраивают тут прежде всего в этой канве, а не для к*динга и прочих не связанных с РП агентностей.
>>1727018 Мистралю тюны не нужны - он мозгов и так хуй да нихуя, а останется ещё меньше, и всё взамен на больше слопа, какой то тюн может даже полностью сломать контекст и тд
>>1727005 А какое железо и модель? Дампом кэша в рам пользуешься? > пробовал задирать контекст, но там такие галюны начинаются Хм, а что там происходит? Или речь про модель с 256к и yarn? И про связку с pi расскажи, вызываешь его командой и заставляешь суммарайзить/что-то делать? > Поэтому я такие штуки превентивно всегда очень поддерживаю Все правильно, развитие это всегда хорошо.
>>1727008 >Люди пришли сюда, читая название треда, долбич Ну, тебя слово локальные не смутило? Что ты блять собираешься делать локально, если не кум? Под другие задачи пиздуй по апишкам, с их триллионами параметров и анальными запретами, они под это больше заточены энивэй.
>>1726957 >то почему они еще не выпускают свои карты в народ? Вон уже пишут что тренят на своем железе.
Так из карт есть только Хуанг. даже AMD еще никак не может допилить свои карты толком. Почитай доки к ROCM - там просто треш и угар, половина неактуальна, вторая половина это тестирование фич на тебе.
А Китай еще хуже в плане поддержки. К тому же США запрещают все китайское.
Кэш никогда в оператос не дампил, потому что мне все нейронки как одна говорили, что ему скорость первоочередна. Так и сидел на 27B (пробовал ещё всякие OSS-120B, 35B-A3B и подобные, остался не доволен).
Потом оффлоад PLE / N-gram embedding table в оперативку не подвезли для vLLM, тогда же на Flash Next и переехал.
>Хм, а что там происходит? Или речь про модель с 256к и yarn?
Да, про него. У той же 27Б нативный контекст 256к только. Происходит - галюны. Просто как будто какой-то рандомный генератор токенов без контекста врубается. Может составить саммари для самого себя, где внезапно на середине переключится в какую-то дичь, как будто письмо дедушке на деревню пишет, лол. Ну и ессно никакой точностью там уже не пахнет, а сидеть за ним вычитывать - я ебал. В общем, выключил. Щас вот с нынешним Flash Next всё же хочется расшиться до 512к контекста, но вспоминая тот опыт как-то хз, наблюдаю за новостями.
>про связку с pi расскажи, вызываешь его командой и заставляешь суммарайзить/что-то делать?
Использую связку (bridge). У Гермеса последних версий есть встроенный инструментарий для делегации задания стороннему исполнителю. Ему в soul.md прописывается инфа об этом, далее он как только видит кодерскую или девопскую задачку - врубает режим проджект манагера, генерит ТЗ для исполнителя (Pi), передаёт ему команду (тот умеет так же нативно принимать), тот генерит сворм агентов (маленький айти-отдел) и начинает веслать. Отдаёт в обратку результат, Гермес его проверяет и либо отправляет на доработку, либо принимает.
Бонус от этого в первую очередь - как раз экономия контекста. У Гермеса окно конь-текста не забивается левыми ненужными данными, логами, результатом выполнения команд, и т.д. - это всё в задачах у Pi висит (и потом прибирается по ненадобности). В в свою очередь Pi своим пиздюкам сабагентам ставит максимально прямые и четкие задачи, буквально "сходи туда, выполни команду N, принеси результат", поэтому и у него контекст не уезжает никуда.
И всё это уживается на одном серваке, если что.
>Все правильно, развитие это всегда хорошо.
Я до сих пор в шоке с vLLM\Strata и запуска Flash Next. Буквально бодрый умный чатгпт у меня дома. Охуеть.
>>1727008 Два чаю. Локальные нейронки != кум треду. Пусть пиздуют в /nf. В конце концов есть и провайдеры, которые разворачивают топ кум нейронки. Бизнес на дрочерах обходится дешевле всяких гигаопусов.
>>1727049 >исследовать годны ли локальные ЛЛМ на что то еще кроме кума Конечно годны. ЛЛМ может быть гейммастером построенной под неё платформы. Например сделать там систему локаций, названий, описаний, и сделать так, что всё это по частному для каждого элемента системному промпту будет заполнять именно ЛЛМ.
Я спрашивал вас здесь о таком недавно. Мне никто не ответил, что такое есть.
>>1727064 Говно залетное, ты пришел в наш тред и нагло тут устанавливаешь порядки? А ты не охуел вообще? Для кодинга и агентов вам уже выделили тред, съеби туда нахуй.