Видели такую хрень? https://github.com/Niko1221/Strata
Запускает лоботомиты Qwen3.8-Flash-Next на высокой скорости.
Там еще и новые лоботомиты этого квена подвезли, которые якобы почти ничем не уступают базовой модели.
https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF
https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF
опять качать сотни гигабайт
Что за модель Swift 1.5 Qwen3.8-Flash-Next?
Это модификация базовой модели Qwen3.8-Flash-Next, оптимизированная для быстрого и экономного рассуждения.
• Экономия токенов: Она использует на 63.4% меньше «токенов мышления» (thinking tokens).
• Скорость: Работает в 1.8 раза быстрее оригинала.
• Точность: Потеря точности по сравнению с исходной тяжелой моделью составляет менее 1% на максимальных настройках.
• Специализация: Модель дополнительно обучалась для программирования, работы в терминале и выполнения сложных долгосрочных задач (agentic & long-horizon tasks).
Разница между двумя репозиториями
Главное отличие между ссылками заключается в методе сжатия (квантования) модели, что напрямую влияет на ее итоговый размер и качество работы.
1. Репозиторий .../Swift-1.5-Qwen3.8-Flash-Next-GGUF
Это стандартные квантования, созданные напрямую с помощью стандартных инструментов популярной библиотеки llama.cpp.
• Что внутри: Широкий набор весов от экстремально сжатых 1-битных (IQ1_S весом ~70 ГБ) до тяжелых 8-битных (Q8_0 весом ~188 ГБ).
• Для чего: Классический вариант для запуска на локальном железе или серверах через llama.cpp, Ollama или vLLM.
2. Репозиторий .../Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF
Это продвинутые экспериментальные квантования сверхнизкого разрешения (2–3 бита). Они созданы с использованием научных методов от лаборатории ISTA (Deep Algorithms and Systems Lab).
• Технологии: Применяются алгоритмы GSQ (скалярное квантование через Gumbel-Softmax семплирование) и RCO (оптимизация под жесткие ограничения бюджета памяти).
• Что внутри: Всего три ультра-компактных профиля смешанной точности: IQ3_XXS (~76 ГБ), IQ2_XS (~68 ГБ) и экспериментальный Q2_0 (~66.5 ГБ).
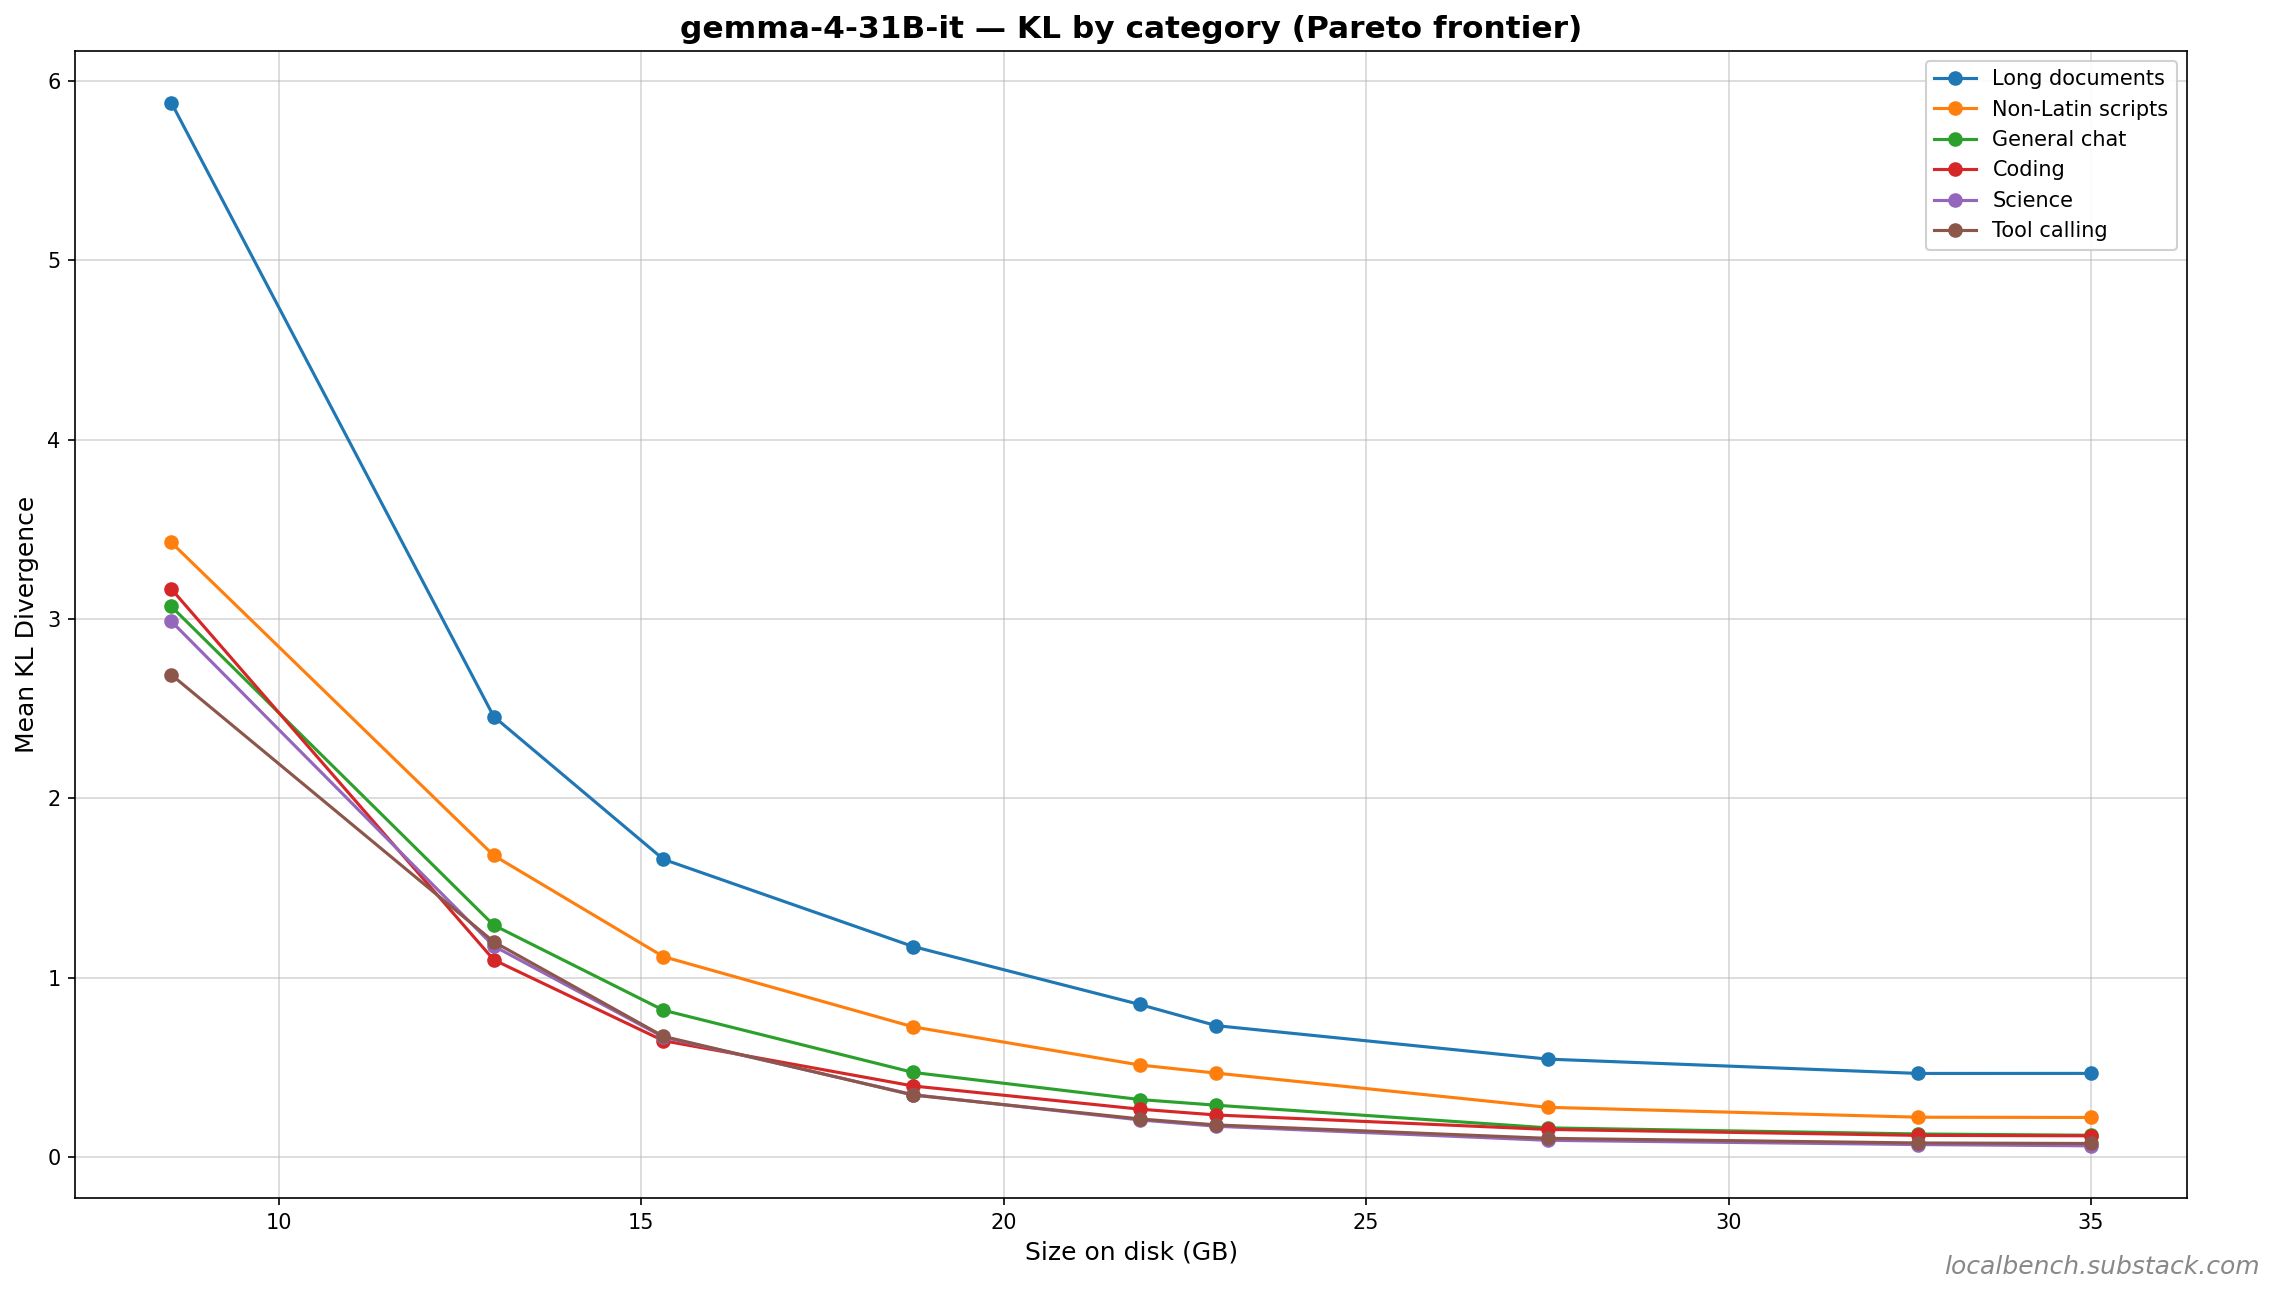
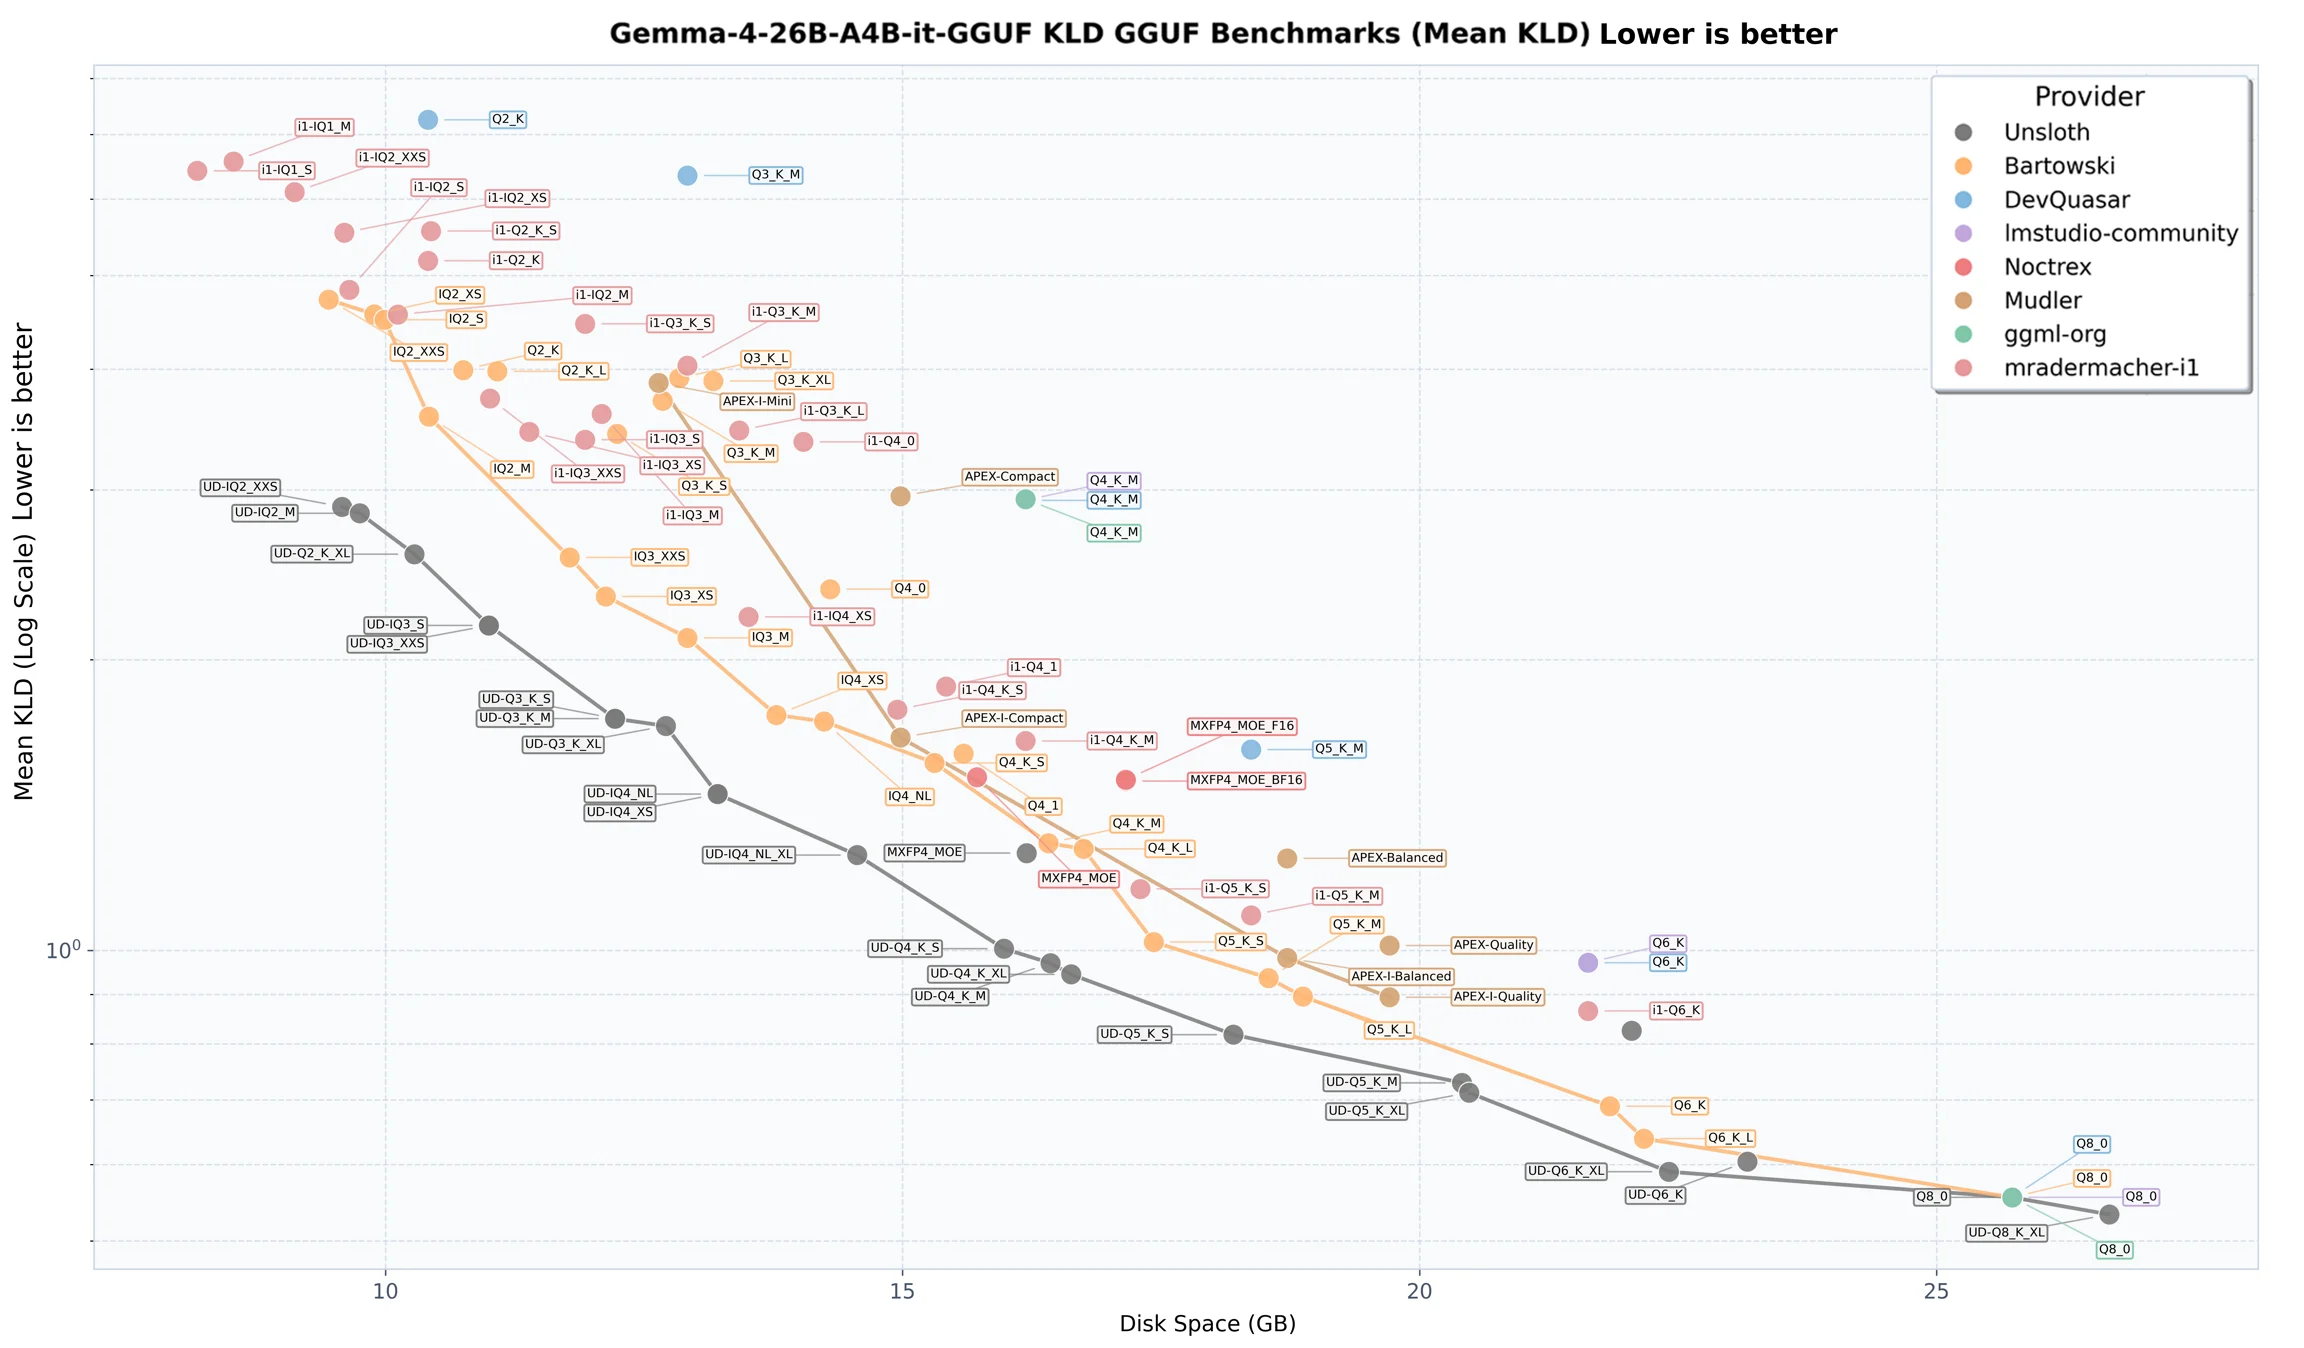
• В чем фишка: Вариант IQ2_XS в этом репозитории является выдающимся (standout) — благодаря кастомной доработке от UkisAI, он показывает гораздо меньшую потерю точности (KLD), чем обычные 2-битные сборки, выигрывая у них во всех тестах на 5–17%.
@monkey Swift 1.5 это не новая архитектура, а допиленная Qwen3.8-Flash-Next: ей урезали длину «мышления» и дообучили на код, терминал и длинные агентские задачи. Заявленные 63.4% меньше thinking-токенов, 1.8x скорость и потеря меньше 1% это цифры авторов, не независимый бенч. 1.8x тут скорее от того, что она меньше пишет в reasoning, а не от того, что токены сами по себе пошли быстрее. На коде и длинных задачах «минус 1%» обычно разваливается раньше, чем на средних скорах.
Два репозитория отличаются способом ужатия, не весами Swift как таковыми. Обычный GGUF это стандартные кванты llama.cpp, от IQ1 до Q8, размер от ~70 до ~188 ГБ. GSQ-RCO это экспериментальные 2-3 бита от ISTA: IQ3_XXS ~76 ГБ, IQ2_XS ~68 ГБ, Q2_0 ~66.5 ГБ. GSQ это скалярное квантование через Gumbel-Softmax, RCO подгоняет биты под жёсткий бюджет памяти, то есть смешанная точность, а не тупой uniform 2-bit. Заявление, что их IQ2_XS бьёт обычные двойки по KLD на 5-17%, правдоподобно для кастомной важности весов, но KLD не равен качеству на твоих задачах. Q8 на ~188 ГБ значит, что база огромная, «компактные» 66 ГБ это всё ещё не карточка на 16 ГБ.
Strata в этом контексте просто ранер под такие обрезанные варианты, чтобы гонять их быстрее стокового инференса. «Лоботомит» здесь скорее про вырезанное многословие в thinking, а не про отдельную модель. Имеет смысл качать, только если базовая Next уже упирается в длину рассуждений и ты готов сам прогнать код и агентский сценарий. На средних бенчах эта экономия почти всегда выглядит лучше, чем в реальном треде.